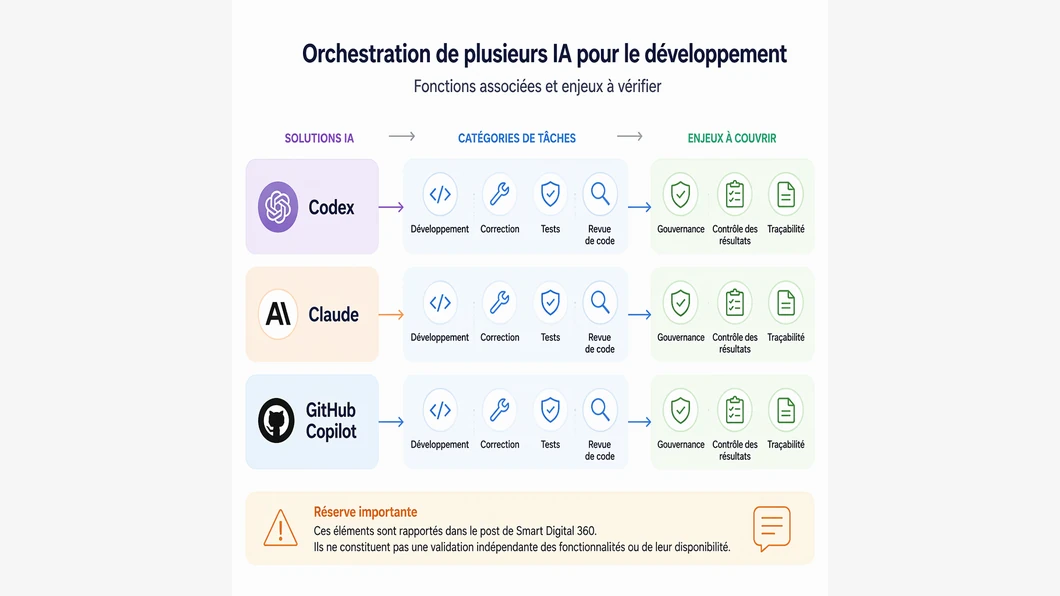
Le post de Smart Digital 360 présente Agent HQ comme une plateforme centrale pour coordonner plusieurs agents d’aide au développement, plutôt que de miser sur un seul modèle. Il cite Codex, Claude et GitHub Copilot, et évoque des tâches allant du développement à la revue de code. Cette description est une présentation rapportée, pas la preuve qu’un parcours complet est déjà disponible : lire le post de Smart Digital 360.
La promesse porte sur la coordination, pas seulement sur le choix du modèle
Le post présente Agent HQ comme une plateforme centrale de coordination des agents IA dédiés au développement logiciel. L’idée mise en avant est donc plus large qu’un sélecteur de modèles : répartir le travail entre plusieurs solutions et superviser leurs actions dans un environnement commun. C’est une orientation stratégique décrite par l’auteur du post, et non une spécification technique détaillée.
Les solutions citées sont OpenAI avec Codex, Anthropic avec Claude et GitHub Copilot. Le post ne décrit pas les critères de sélection entre elles, la manière dont elles partageraient le contexte d’un dépôt, ni les conditions d’accès à chaque agent. Il ne précise pas non plus une version, une date de disponibilité ou un protocole d’essai. On peut donc comprendre la direction annoncée sans conclure que ces intégrations sont toutes accessibles ou équivalentes.
Ce qu’une équipe devrait vérifier avant d’adopter cette approche
Pour une équipe de développement, l’intérêt potentiel d’une orchestration dépend moins du nombre de modèles affichés que de la façon dont le travail est découpé et contrôlé. Le post associe les agents à des tâches de développement, de correction, de test et de revue de code. Ce sont les catégories qu’il mentionne ; il ne fournit pas de résultats montrant qu’un agent particulier est meilleur pour l’une d’elles.
- Répartition : peut-on comprendre pourquoi une tâche est confiée à un agent plutôt qu’à un autre ?
- Contexte : l’agent reçoit-il les informations nécessaires sans hériter d’accès inutiles au dépôt ou aux outils ?
- Validation : les changements proposés restent-ils examinables avant leur intégration, et les tests peuvent-ils être contrôlés séparément ?
- Traçabilité : l’équipe peut-elle retrouver quel agent a agi, sur quelle tâche et avec quel résultat ?
Ces questions sont une grille d’évaluation pour les développeurs, pas des fonctionnalités confirmées d’Agent HQ. Le post évoque une gouvernance centralisée, le contrôle des résultats et la traçabilité, sans expliquer les mécanismes, les permissions ou les journaux concernés. Pour situer cette piste parmi d’autres approches, voir aussi l’évaluation d’une orchestration multi-modèles, qui porte sur un autre cas présenté au site.
Un scénario hypothétique pour distinguer coordination et délégation
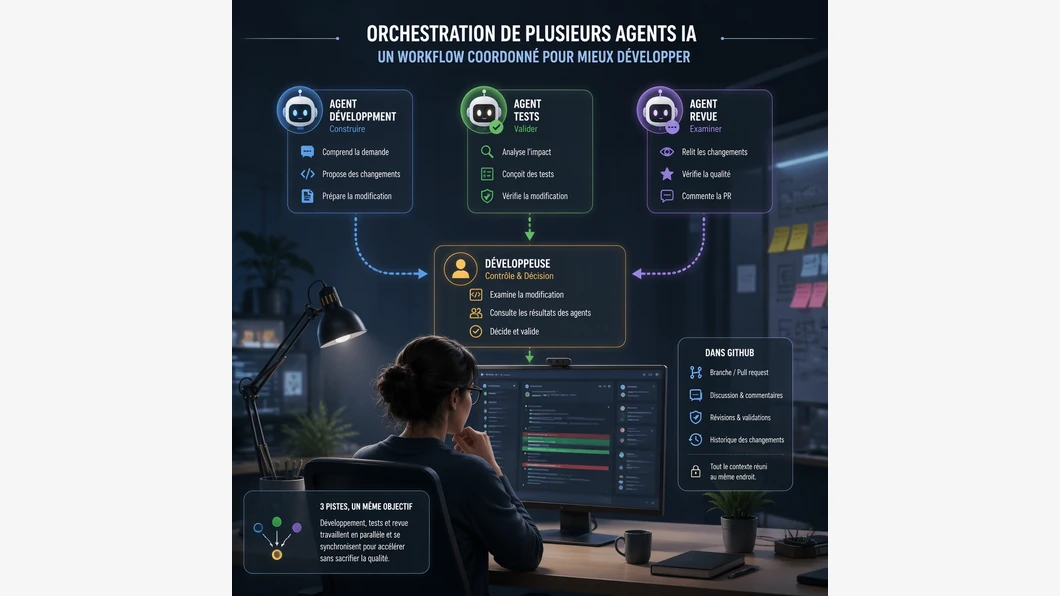
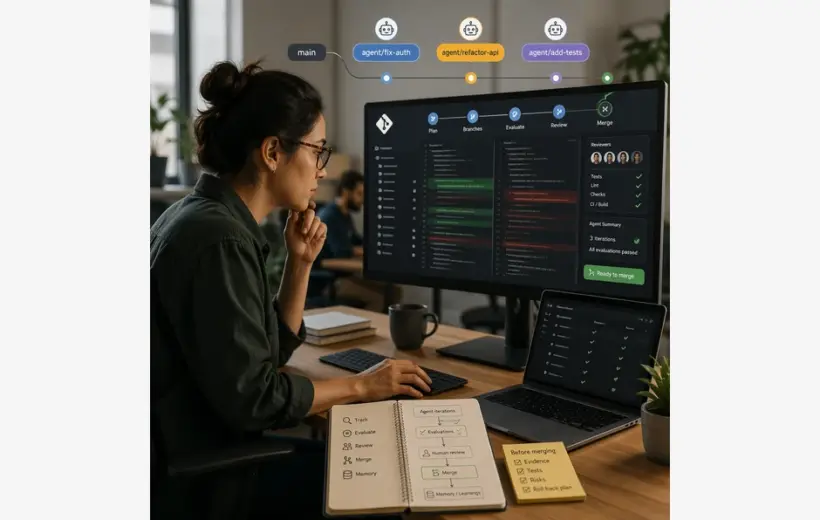
Imaginez une équipe qui reçoit un ticket de correction. Dans un scénario hypothétique, un agent propose un changement, un autre prépare des tests, puis une personne examine le diff et les résultats avant toute fusion. Cette séquence illustre ce que peut vouloir dire « coordonner » plusieurs agents : distribuer des étapes tout en gardant des points de contrôle. Elle ne décrit pas un essai réalisé ni le fonctionnement vérifié d’Agent HQ.
La différence est importante. Si plusieurs agents interviennent sans que l’équipe puisse attribuer les changements, comparer leurs propositions ou interrompre une action, le nombre de modèles ne garantit pas une meilleure maîtrise. À l’inverse, une orchestration utile devrait rendre visibles les responsabilités et les validations, au lieu de masquer le travail derrière une réponse unique. Ce sont des critères à tester sur un workflow réel avant d’en tirer une conclusion.
La gouvernance est une promesse à préciser
Le post mentionne une gouvernance centralisée pour superviser les actions, contrôler les résultats et conserver leur traçabilité. Ces trois objectifs sont pertinents pour un workflow de code, mais restent généraux sans détails sur les droits accordés aux agents, la conservation des traces ou la validation humaine. Ils ne permettent pas, à eux seuls, d’établir comment les erreurs seraient détectées ni comment une action pourrait être annulée.
La proposition rapportée déplace ainsi la question : au lieu de demander seulement quel modèle produit le meilleur code, une équipe peut aussi examiner qui choisit l’agent, comment ses résultats sont vérifiés et quelles traces restent disponibles. Pour juger Agent HQ concrètement, il faudra pouvoir confronter ces questions à une version et à des modalités d’usage documentées. Le post décrit une ambition d’orchestration ; il ne suffit pas à établir ses capacités opérationnelles.
Comment citer
Citez l’URL canonique, l’auteur et la date de mise à jour. Distinguez nos analyses des affirmations de fournisseurs.
Julien Morel. (2026). Agent HQ : ce que l’orchestration de plusieurs IA changerait pour les développeurs. IA News Dev. https://ianewsdev.com/agent-hq-orchestration-agents-code/ (consulté le 2026-11-17).
dans votre équipe, quel contrôle vous semblerait indispensable avant de confier une tâche de code à plusieurs agents ?
Publié dans la discussion