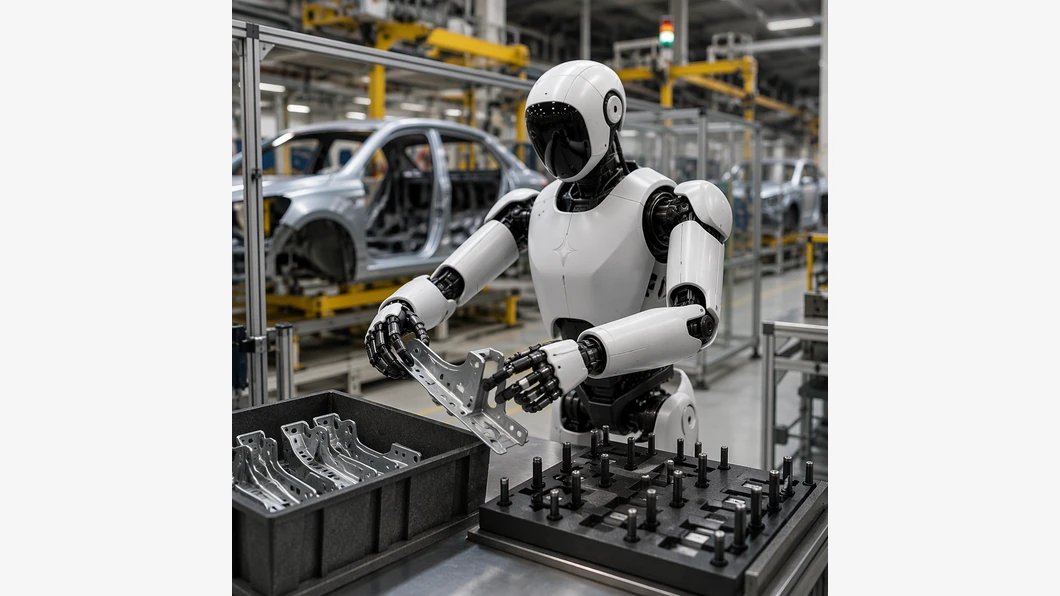
Pour évaluer Gemini Robotics 2.5, la question utile n’est pas seulement de savoir si un robot peut saisir un objet. Il faut regarder la variété des tâches, la réussite dans un environnement de travail et les conditions dans lesquelles ces résultats ont été obtenus. Google DeepMind présente des évaluations sur plus de 200 tâches et un pilote de préparation de pièces automobiles avec Apollo 2. Ces éléments éclairent des capacités précises, mais ne constituent pas à eux seuls une preuve de déploiement industriel généralisé.
La publication de Google DeepMind sur Gemini Robotics 2.5 distingue notamment la dextérité, la fiabilité et la sécurité. Pour les équipes qui suivent la robotique incarnée, ces dimensions ne se confondent pas : réussir une manipulation délicate dans une évaluation, tenir une tâche répétitive sur une ligne active et éviter un obstacle relèvent de problèmes différents.
1. Distinguer l’étendue des tâches de la réussite en situation
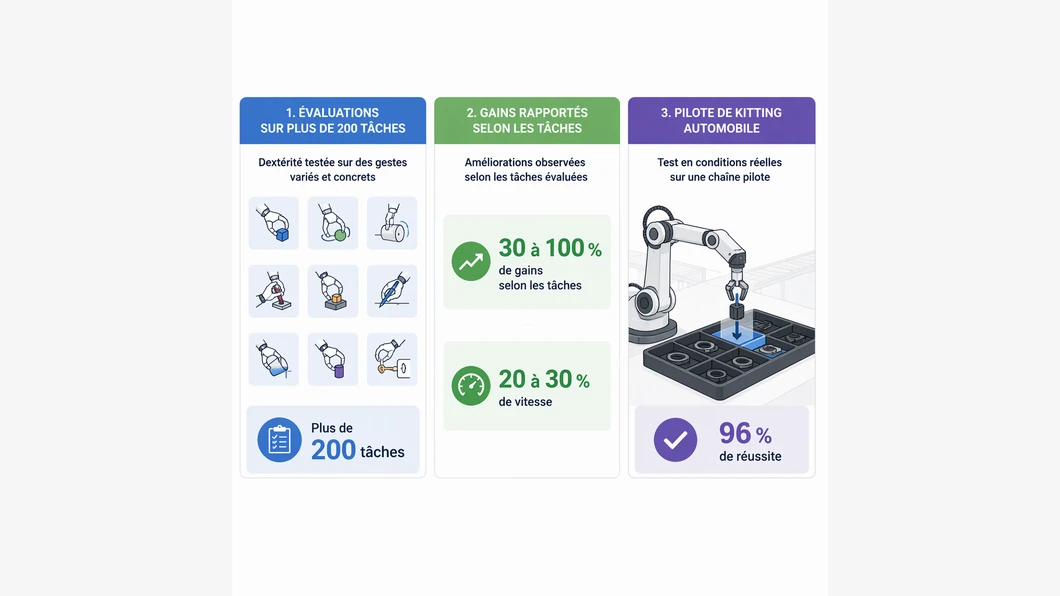
DeepMind indique avoir évalué le modèle sur plus de 200 tâches distinctes. Les exemples cités vont du service avec des pinces au nouage d’un ruban, en passant par le pipetage. Le point important est la combinaison de compétences : usage d’outils, manipulation d’objets déformables et prise en charge d’objets délicats. Une évaluation couvrant plusieurs familles de gestes renseigne davantage sur la diversité des capacités que la réussite sur une seule démonstration.
La publication rapporte, par rapport à des références antérieures, des taux de réussite supérieurs de 30 à 100 % selon le type de tâche, et des exécutions 20 à 30 % plus rapides. Ces valeurs sont présentées par l’éditeur comme les résultats de ses évaluations. La plage dépendant du type de tâche, elle ne doit pas être lue comme une amélioration uniforme pour toute manipulation ni comme une mesure indépendante.
Le modèle est aussi décrit comme compatible avec plusieurs types de robots : Apollo 2, équipé d’une main SharpaWave à cinq doigts et 22 degrés de liberté, ainsi que la plateforme Franka Duo avec des pinces parallèles à deux doigts. Cette variété de matériel rend la question de la transférabilité intéressante, mais la publication ne fournit pas ici un protocole détaillé permettant de comparer directement les performances entre ces plateformes.
2. Lire le pilote automobile comme un cas d’usage délimité
Le cas industriel rapporté concerne une preuve de concept menée avec Apptronik et Mercedes-Benz sur des lignes de production à Kecskemét, en Hongrie, et à Sindelfingen, en Allemagne. Apollo 2 effectue du kitting automobile : il prélève des pièces dans des bacs en vrac puis les place dans des plateaux organisés selon l’ordre nécessaire à chaque véhicule.
DeepMind rapporte un taux de réussite de 96 % pour ce pilote. Le chiffre porte sur cette tâche de préparation et sur le cadre décrit par l’éditeur ; il ne signifie pas que le robot réalise 96 % de toutes les opérations d’une usine, ni qu’il fonctionne sans supervision dans n’importe quelle ligne. La source ne précise pas, dans les passages disponibles, le nombre d’essais, la durée de mesure ou la définition détaillée d’une réussite. Ces paramètres seraient nécessaires pour reproduire et comparer le résultat.
La publication distingue deux composants : Gemini Robotics ER suit le déroulement du travail, tandis que le modèle d’actions Gemini Robotics 2.5 contrôle les bras et les mains. Le robot saisit des supports métalliques, les déplace vers des contenants de séquencement et corrige les écarts. Cette séparation entre raisonnement sur la tâche et contrôle des actions est utile pour comprendre l’architecture présentée, sans préjuger de la facilité de son intégration dans d’autres environnements.
3. Comparer les preuves sans mélanger leurs périmètres
| Élément rapporté | Ce qu’il décrit | Prudence de lecture |
|---|---|---|
| Plus de 200 tâches | Évaluations de largeur, performance et complexité | Ne fournit pas à lui seul le détail de chaque tâche ou de son poids dans le résultat global. |
| 30 à 100 % de réussite supérieure | Comparaison à des références antérieures, variable selon la tâche | La plage n’est pas un gain uniforme et reste rapportée par l’éditeur. |
| 20 à 30 % plus rapide | Temps d’exécution rapporté pour les évaluations | À interpréter avec les tâches et conditions de comparaison correspondantes. |
| 96 % de réussite | Pilote de kitting automobile avec Apollo 2 | Résultat circonscrit à la preuve de concept décrite, pas à l’ensemble d’une usine. |
Ce tableau sépare les résultats d’évaluation du pilote réel, car ils ne répondent pas à la même question. Les premiers portent sur un ensemble de tâches conçu pour sonder les capacités ; le second montre une application sur une ligne active, mais dans un périmètre spécifique. Pour aller plus loin, il faudrait disposer du protocole complet, des conditions d’échec et d’éléments de répétition indépendante.
4. Examiner la sécurité comme une capacité distincte
DeepMind rapporte que le guidage de raisonnement à l’inférence permet au robot d’éviter des dangers physiques en temps réel. Dans ses évaluations, cette capacité augmente de 33 % la réalisation sûre des tâches autour d’obstacles et de 43 % à proximité de personnes. Ces indicateurs portent sur des scénarios évalués par l’éditeur : ils ne démontrent pas l’absence de risque dans toutes les configurations d’atelier.
La publication mentionne également ASIMOV-Jailbreak, un benchmark open source destiné à tester des demandes dangereuses dissimulées dans des scènes robotiques. Le score de résistance de 99,5 % cité concerne Gemini 4 Argon, comparé à 82 % pour Gemini Robotics ER 2 ; il ne s’agit pas du score de Gemini Robotics 2.5. Séparer ces modèles évite d’attribuer au système évalué des résultats annoncés pour un autre composant.
5. Une grille utile pour suivre les prochaines versions
- Identifier le matériel : noter le robot, les effecteurs et le type de prise concernés avant de comparer deux résultats.
- Décrire la tâche : distinguer manipulation d’objets délicats, usage d’outils et séquencement de pièces.
- Conserver le dénominateur : demander le nombre d’essais, les critères de réussite et la durée observée lorsqu’ils sont publiés.
- Séparer les environnements : ne pas assimiler une évaluation de tâches à un pilote sur une ligne active.
- Isoler la sécurité : relever les scénarios de proximité humaine et d’obstacles, sans transformer un score ciblé en garantie générale.
Cette lecture par périmètre complète les repères sur les agents IA pour développeurs et leurs limites : dans les deux cas, une capacité annoncée doit être rapportée à la tâche, au contexte d’exécution et aux contrôles qui l’entourent. Pour Gemini Robotics 2.5, les informations publiées dessinent une progression sur la variété des manipulations et un cas industriel concret. Elles ne suffisent pas à conclure que le passage à l’échelle, la disponibilité commerciale générale ou la fiabilité sur d’autres opérations sont acquis.
Comment citer
Citez l’URL canonique, l’auteur et la date de mise à jour. Distinguez nos analyses des affirmations de fournisseurs.
Julien Morel. (2026). Gemini Robotics 2.5 : ce que les essais industriels disent de sa dextérité. IA News Dev. https://ianewsdev.com/gemini-robotics-25-dexterite-essais-industriels/ (consulté le 2026-11-17).
quel indicateur vous semblerait indispensable pour évaluer un robot sur une ligne de production ?
Publié dans la discussion