Un agent qui travaille longtemps doit gérer plus que la taille de sa fenêtre de contexte : il lui faut aussi décider quelles informations garder, lesquelles écarter et où noter l’avancement. Les Context Language Models (CLM) explorent une autre réponse aux stratégies habituelles : laisser le modèle modifier son propre contexte au lieu de confier cette tâche uniquement à un mécanisme externe. Le compte rendu d’InfoQ attribue cette approche à des chercheurs de Meta, du MIT et de l’Université de Washington. Le compte rendu d’InfoQ sur les Context Language Models rapporte des gains sur plusieurs tâches, mais ne suffit pas à établir qu’un outil prêt à l’emploi les reproduira dans un dépôt logiciel réel.
Du contexte à consulter au contexte que le modèle peut éditer
Dans les systèmes classiques décrits par InfoQ, le contexte est contenu par des opérations telles que le résumé, la compression ou la récupération d’informations depuis une mémoire externe. Chacune impose une forme de sélection. Un résumé peut perdre un détail ou introduire une erreur ; une compression peut appliquer des règles définies à l’avance ; une mémoire externe suppose qu’un agent choisisse quoi récupérer et à quel moment. Le problème n’est donc pas seulement de limiter la quantité de texte : il faut préserver les éléments qui restent utiles pour la tâche.
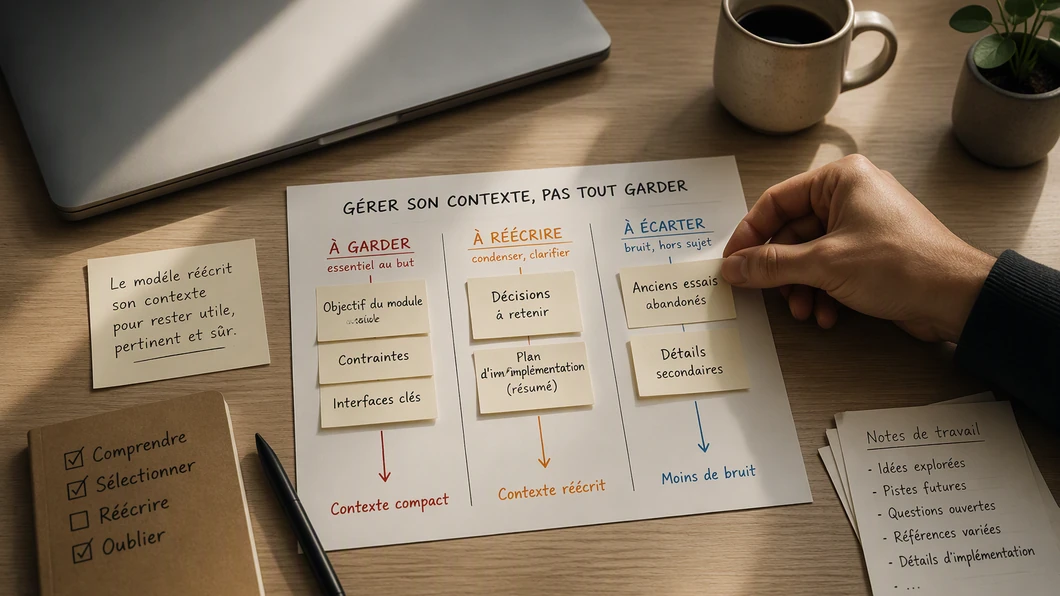
Un CLM traite plutôt le contexte comme un fichier que le modèle peut mettre à jour. Il peut réécrire d’anciens messages, conserver des faits importants, supprimer des éléments jugés hors sujet et tenir des notes de progression. Le modèle peut aussi consigner des tentatives infructueuses avec des pistes à explorer. L’idée est de faire de la gestion du contexte une partie du comportement appris, plutôt qu’une suite de règles entièrement déterminées par l’environnement de l’agent.
La différence est importante pour le développement : il ne s’agit pas simplement d’ajouter une mémoire à un agent, mais de lui laisser une marge de décision sur la représentation de son état de travail. Les contenus maintenus peuvent orienter les étapes suivantes, et le modèle peut apprendre des procédures de gestion réutilisables. Cela ne signifie pas pour autant qu’il sait toujours distinguer une contrainte essentielle d’un détail provisoire.
Trois façons d’apprendre cette gestion
Le compte rendu distingue trois approches. Elles ne correspondent pas à trois produits, mais à différentes manières de laisser le modèle gérer son contexte :
| Approche | Comment elle est décrite | Ce qu’elle permet d’examiner |
|---|---|---|
| Zero-shot | Le modèle reçoit la tâche sans entraînement spécifique à la gestion du contexte. | Ce qu’il peut faire sans stratégie de gestion explicitement apprise. |
| Apprentissage en contexte | Des instructions en langage naturel guident la stratégie, qui est affinée par une boucle d’optimisation des compétences. | La possibilité de guider la méthode sans modifier les règles de gestion externes. |
| Apprentissage par renforcement | La réussite de la tâche sert d’objectif principal ; l’efficacité de calcul est aussi prise en compte. | La façon dont réussite et coût de calcul sont intégrés à l’optimisation. |
Dans l’approche guidée en contexte, l’utilisateur peut demander une stratégie de gestion particulière. Le modèle peut également faire évoluer un document interne de compétences qui conserve des procédures utiles pour de futures tâches. Ces possibilités décrivent un mécanisme de recherche ; elles ne constituent pas une garantie qu’une consigne donnée sera suivie correctement dans tous les cas.
Des résultats rapportés, à lire tâche par tâche
InfoQ rapporte plusieurs résultats sur des benchmarks et des tâches d’agents. En zero-shot, les CLM auraient obtenu une précision supérieure de 11,4 % tout en utilisant 21,5 % de FLOPs en moins sur BrowseComp-Plus. Sur EdgeBench, dans la tâche de 12 heures mentionnée, le compte rendu indique un score supérieur de 5 % avec 59 % de FLOPs en moins. Ce sont des résultats rapportés pour ces évaluations précises, pas une mesure générale de la qualité ou du coût d’un agent de développement.
Le compte rendu mentionne aussi, pour l’apprentissage en contexte, une amélioration de la précision allant jusqu’à 35,9 points sur des tâches ContextBench avec un calcul inférieur. Dans l’expérience par renforcement sur BrowseComp-Plus, le score de Qwen3.5-9B passe, selon ce même compte rendu, de 28,8 % à 42,5 %, soit une amélioration relative de 47,6 %, avec 12 % de FLOPs en moins. Ces chiffres ne doivent pas être fusionnés en un classement unique : ils portent sur des méthodes et des tâches différentes.
Pour une équipe technique, la conclusion raisonnable est donc circonscrite : apprendre au modèle à gérer son contexte pourrait améliorer le compromis entre réussite et calcul dans les scénarios évalués. Les valeurs rapportées ne donnent pas, à elles seules, le coût d’intégration, le comportement sur un dépôt particulier ni le résultat d’une comparaison indépendante. Le compte rendu ne fournit pas un protocole de reproduction complet pour transformer ces nombres en essai directement exécutable par une équipe.
Ce que l’autogestion du contexte ne résout pas
La capacité d’édition crée aussi un risque propre. InfoQ rapporte que le modèle peut supprimer une information importante qu’il ne saura pas récupérer ensuite. Il peut également prendre de mauvaises décisions sur les éléments à conserver, modifier ou effacer. Une mémoire plus facile à modifier n’est donc pas nécessairement une mémoire plus fiable.
Un autre point concerne les instructions malveillantes : le compte rendu signale que le contexte éditable peut devenir un canal où des prompt injections ou des instructions produites par le modèle persistent d’un tour à l’autre. Si une instruction nuisible est conservée dans les notes qui guident la suite, l’édition autonome peut prolonger son influence au lieu de la faire disparaître. La gestion du contexte touche alors à la fois à la qualité de l’agent et à sa sécurité.
Ces enjeux prolongent, sans se confondre avec, les questions de choix entre instructions, recherche et mémoire abordées dans notre comparatif des canaux de contexte pour agents de code. Ils diffèrent aussi d’une approche où l’équipe traite les consignes comme un actif versionné : la méthode du context as code porte sur la maintenance et le contrôle de cet actif, tandis que les CLM portent sur la capacité du modèle à gérer lui-même son contexte.
Les questions à poser avant un essai dans un agent de code
Les chiffres publiés ne remplacent pas une évaluation adaptée à la tâche visée. Pour cadrer un éventuel essai, une équipe peut rendre explicites quatre points, sans présumer du résultat :
- Quelles informations l’agent doit-il conserver pour terminer la tâche, et lesquelles peut-il supprimer sans perdre une contrainte ou une décision importante ?
- Comment repérer qu’une note erronée ou une instruction indésirable a été conservée d’un tour à l’autre ?
- Peut-on comparer, sur les mêmes tâches, le résultat obtenu avec gestion autonome et avec une stratégie de contexte définie à l’avance ?
- Les mesures suivent-elles séparément la réussite et le calcul utilisé, plutôt que de présenter l’un comme un substitut à l’autre ?
Ces questions forment un protocole à concevoir, pas le récit d’un test déjà effectué. Avant d’accorder davantage d’autonomie à un agent, il faut notamment savoir comment inspecter les modifications de contexte et examiner les échecs de sélection. L’intérêt des CLM est de déplacer une partie de ce travail vers le modèle ; leur limite centrale est de confier aussi au modèle des décisions qui peuvent affecter les tours suivants.
Les résultats rapportés rendent cette piste intéressante pour les systèmes qui doivent gérer un contexte durable, mais ils ne tranchent ni sa fiabilité en production ni son adéquation à chaque workflow de développement. La décision pratique dépendra de la tâche, de la possibilité de contrôler les changements de contexte et de la manière dont les erreurs de conservation ou d’effacement sont détectées.
Comment citer
Citez l’URL canonique, l’auteur et la date de mise à jour. Distinguez nos analyses des affirmations de fournisseurs.
Julien Morel. (2026). Context Language Models : quand le modèle réécrit lui-même son contexte. IA News Dev. https://ianewsdev.com/context-language-models-gestion-contexte/ (consulté le 2026-10-20).
quelle information un agent de code devrait-il toujours conserver dans son contexte de travail ?
Publié dans la discussion