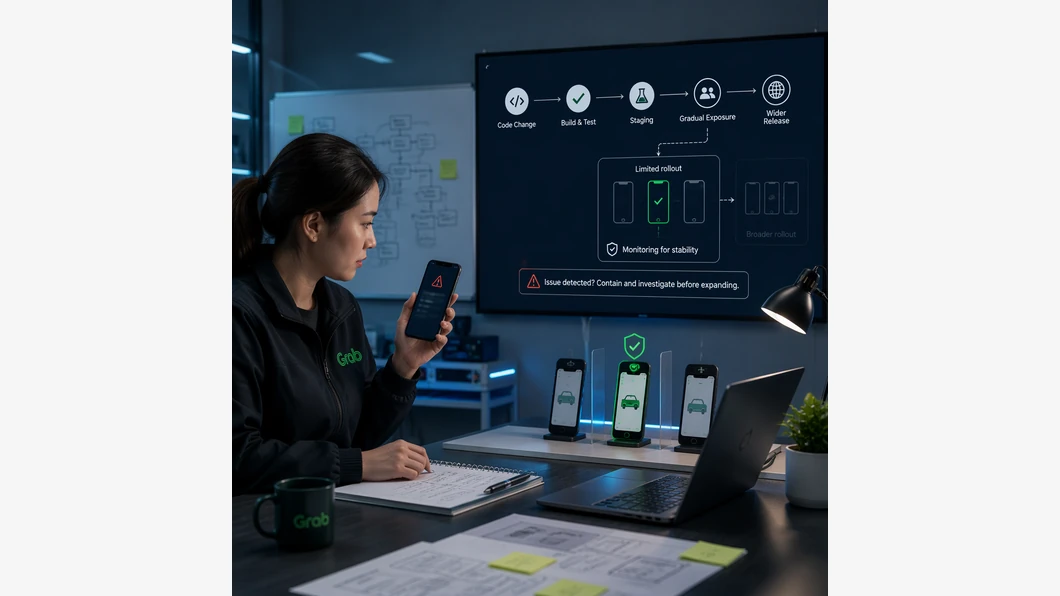
Quand le volume de changements augmente, éviter un crash mobile ne repose pas sur un contrôle unique placé à la fin du développement. Grab décrit une défense répartie entre prévention avant fusion, exposition graduelle en production et intervention après détection. L’intérêt de cette approche tient à l’enchaînement des barrières : chacune vise un moment différent où un défaut peut encore être repéré ou contenu.
Le contexte compte. Selon le récit publié par InfoQ, qui rapporte les explications de Grab, davantage de changements par version signifie aussi davantage d’occasions d’introduire des défauts. Dans l’organisation décrite, plusieurs équipes fusionnent régulièrement du code et certaines fonctionnalités sont activées indépendamment des versions de l’application. Un changement peut donc affecter les utilisateurs sans que toutes les modifications soient mises en service au même moment.
Le risque mobile ne s’arrête pas au lancement. Grab souligne qu’un crash peut dégrader l’expérience et affecter le taux de sessions sans crash. De plus, les utilisateurs qui n’activent pas les mises à jour automatiques peuvent conserver plus longtemps une version défectueuse. Et lorsqu’une trace d’appel n’est pas correctement symboliquée, retrouver l’origine du problème peut demander de rapprocher le calendrier des versions, l’activation des fonctionnalités et les métadonnées de session. C’est cette chaîne de conséquences qui rend utile une réponse avant, pendant et après la diffusion.
Avant la fusion : empêcher le défaut de franchir la première barrière
Grab décrit une défense en couches qui cherche à prévenir, détecter et contenir les crashs tout au long du cycle de développement et de mise en production. La première barrière intervient avant qu’un changement ne soit livré. Android Lint et SwiftLint, associés à des règles propres à l’entreprise, servent à relever certains problèmes statiquement. Les vérifications sont complétées par des tests unitaires, des tests d’interface et des contrôles d’assurance qualité.
Ces contrôles ne répondent pas tous à la même question. L’analyse statique peut signaler des motifs de code problématiques ; les tests vérifient des comportements ciblés ; les contrôles QA apportent une autre vérification avant diffusion. Aucun de ces mécanismes ne garantit à lui seul l’absence de crash, et le compte rendu ne détaille pas leur couverture ni leurs résultats chiffrés. L’enseignement opérationnel est plutôt de ne pas confondre une vérification réussie avec une preuve que toute combinaison d’appareil, de session et de fonctionnalité est sans risque.
Grab ajoute un sas de préproduction, Grab Early Access (GEA), où des versions anticipées sont distribuées à des utilisateurs internes et surveillées pour repérer les crashs. Une anomalie observée par un petit groupe peut justifier une enquête avant une exposition bien plus large. Ce contrôle a donc une fonction différente de celle d’un test automatisé : il permet d’observer une version distribuée dans un contexte d’usage interne, sans la confondre avec un déploiement à l’ensemble du public.
Au déploiement : limiter l’exposition et garder une marche arrière
Les contrôles d’avant-fusion ne suffisent pas à détecter toutes les défaillances. Au moment de la diffusion, Grab utilise un déploiement progressif : une nouvelle version est d’abord proposée à une fraction des utilisateurs. L’équipe surveille alors les crashs et peut interrompre le déploiement si leur taux devient anormal. La portée immédiate d’un défaut est ainsi limitée par rapport à une diffusion simultanée à tous les utilisateurs.
Les feature flags constituent une seconde commande, distincte du déploiement de l’application. Une version peut être installée tandis qu’une fonctionnalité demeure désactivée ; son activation graduelle permet d’observer son effet. Selon le compte rendu, Grab peut désactiver immédiatement une fonctionnalité si son taux de crash dépasse des seuils prédéfinis, sans attendre une nouvelle version. Cela ne supprime pas le défaut du code : cela réduit l’exposition à la fonctionnalité concernée pendant que l’équipe traite le problème.
| Moment | Risque visé | Garde-fou décrit |
|---|---|---|
| Avant la fusion et en préproduction | Un défaut rejoint une version distribuable | Analyse statique, tests, QA et surveillance de GEA |
| Pendant le déploiement | Une version défectueuse touche trop d’utilisateurs | Diffusion progressive, surveillance et pause possible |
| Après la mise en production | Un crash échappe au contrôle préalable ou doit être attribué | Détection, diagnostics enrichis, triage et retour d’expérience |
Cette chronologie ne signifie pas que les étapes se remplacent. Le rollout progressif contrôle l’arrivée d’une version ; un feature flag contrôle l’exposition à une fonctionnalité. Les deux leviers répondent à des périmètres distincts et peuvent être utiles lorsque les fonctionnalités ne sont pas activées au même rythme que les versions. Pour une équipe mobile, la question concrète est donc de savoir quelle commande peut réduire l’exposition, et à quel niveau, si une anomalie apparaît.
Après la mise en ligne : relier le signal au changement concerné
Une fois le build en circulation, Grab décrit une surveillance des crashs en temps réel s’appuyant sur Firebase Crashlytics et BigQuery pour repérer des anomalies. Le triage automatisé et des diagnostics enrichis agrègent des métadonnées de crash et des traces d’appel afin d’aider les équipes à relier un incident à des demandes de fusion précises. Cette étape est particulièrement importante lorsque la trace ne suffit pas, à elle seule, à désigner l’origine du problème.
Les outils cités ne remplacent pas l’enquête : ils contribuent à rassembler les éléments dont l’équipe a besoin pour examiner un incident. La corrélation entre une version, une activation de feature flag et les informations d’une session peut aider à resserrer le périmètre d’investigation. Le compte rendu ne précise toutefois ni les seuils employés, ni le délai de résolution, ni le taux de crash avant et après la mise en place de ces contrôles. Il décrit un dispositif, pas une évaluation chiffrée de son efficacité.
Grab mentionne aussi des retours d’expérience et des analyses post-mortem qui servent à étendre les règles de lint et la couverture des tests. La boucle est importante : un incident ne se termine pas nécessairement par la correction du code. Il peut aussi révéler qu’une règle de prévention manque, qu’un scénario de test n’est pas couvert ou qu’un signal de production est difficile à relier à une modification.
Ce que ce cas permet de retenir
Le récit de Grab ne démontre pas que l’IA a causé un crash particulier, ni que les garde-fous ont réduit les incidents d’une quantité mesurée. Il explique plutôt pourquoi l’augmentation du rythme des changements rend utile une chaîne de contrôles couvrant tout le cycle mobile. La génération de code, quelle qu’en soit l’origine, ne rend pas facultatifs la préproduction, la maîtrise de l’exposition et le diagnostic après diffusion.
Pour une équipe qui veut examiner ses propres pratiques, le point de départ est de cartographier les commandes réellement disponibles à chaque étape : quelles vérifications bloquent une fusion, quelle version peut être stoppée, quelles fonctionnalités peuvent être désactivées séparément, et quelles données permettent de relier un crash à son contexte. Les réponses dépendent de l’application et de son architecture ; le cas rapporté ne fournit pas de configuration universelle à copier. Pour approfondir le rôle des contrôles de test dans un flux de développement assisté par IA, consultez aussi les tests automatisés avec l’IA et leurs limites.
Comment citer
Citez l’URL canonique, l’auteur et la date de mise à jour. Distinguez nos analyses des affirmations de fournisseurs.
Julien Morel. (2026). Stabilité mobile chez Grab : contenir les crashs à chaque étape du déploiement. IA News Dev. https://ianewsdev.com/grab-stabilite-mobile-crashs-deploiement/ (consulté le 2026-11-17).
quelle barrière vous aide le plus à contenir un incident mobile, avant ou après sa mise en production ?
Publié dans la discussion