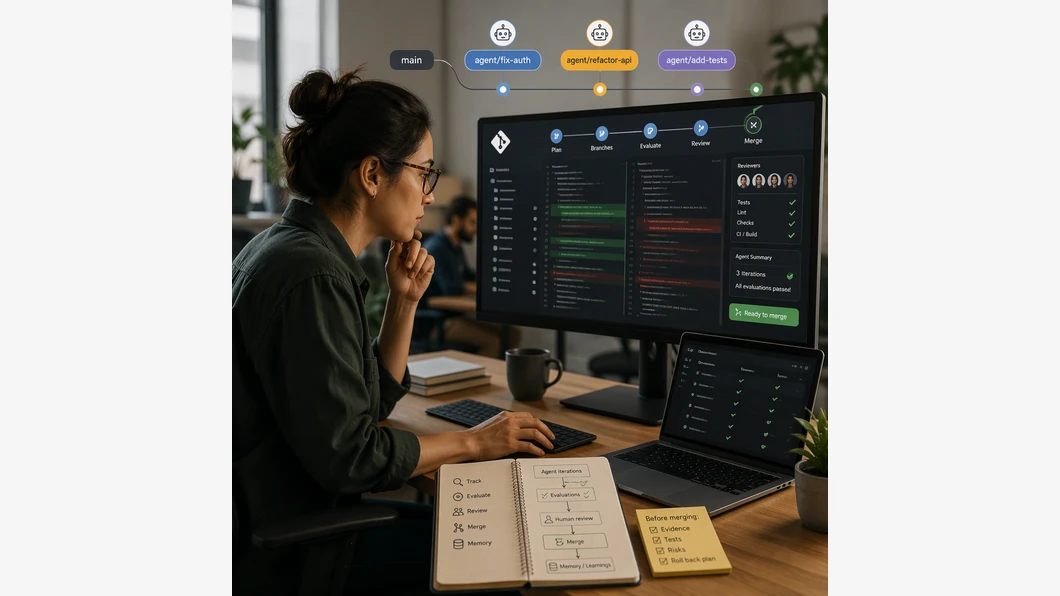
Quand un agent de code pousse plusieurs versions d’un même changement, une pull request classique peut montrer l’historique sans rendre immédiatement lisible l’état de la proposition. Entire aborde ce problème en organisant la collaboration autour de trails : des parcours qui relient une demande, les modifications successives et leurs évaluations. Le compte rendu d’InfoQ du 8 novembre 2026 décrit ainsi une forge Git pensée pour des développeurs qui travaillent avec des agents, plutôt qu’une simple interface de revue enrichie d’IA. Le compte rendu d’InfoQ sur Entire attribue à l’entreprise les caractéristiques et performances annoncées ; il ne fournit pas de validation indépendante de celles-ci.
1. Partir d’une demande, pas seulement d’une pull request
Entire se présente comme une forge Git conçue pour faire collaborer développeurs humains et agents de programmation. Un trail peut démarrer à partir d’un rapport de bug, d’une demande de fonctionnalité ou d’une création manuelle, et s’étendre sur plusieurs dépôts. L’unité de suivi n’est donc pas seulement le diff à relire : c’est aussi la succession des actions et évaluations liées à une demande.
Ce changement de point de départ compte surtout lorsque le travail passe par plusieurs itérations. Une pull request reste utile pour examiner du code, mais son fil de discussion n’explique pas nécessairement, à lui seul, pourquoi un agent a recommencé, ce qui a changé entre deux passages ou si une revue a encore relevé un problème. Le trail est présenté comme une manière de rassembler ces éléments au même endroit. Cela ne dispense pas l’équipe de définir ce qui constitue une demande suffisamment précise ni de décider qui reste responsable de son acceptation.
2. Lire l’évaluation comme une boucle, pas comme un verdict
Dans le mécanisme décrit, chaque nouveau push déclenche une évaluation par un agent de revue exécuté dans un bac à sable cloud. L’évaluation renvoie un score et une justification portant notamment sur la qualité du code, la sécurité, le « slop » et la nécessité d’une revue humaine. La page met en avant le score et sa justification, tandis que les cinq exécutions précédentes et l’exécution courante restent visibles pour chaque évaluation.
Cette répétition apporte un signal différent d’une note isolée : l’équipe peut examiner si une nouvelle modification améliore ou dégrade les évaluations et retrouver les passages précédents. Dans l’exemple rapporté, un score « slop » orange peut conduire à demander à l’agent de retravailler le code ; le nouveau push lance alors une autre évaluation. C’est une boucle d’itération décrite par InfoQ, pas la preuve qu’un score donné mesure correctement la qualité d’un dépôt réel.
Pour l’interpréter, il faut donc lire ensemble le résultat, sa justification et le changement qui l’a déclenché. Un score favorable ne démontre pas à lui seul que le comportement attendu est correct, que les tests couvrent le risque ou que la modification respecte les contraintes du projet. Inversement, la valeur pratique d’un signal dépend de la façon dont ses critères sont définis et de la possibilité pour les personnes chargées de la revue de contester ses conclusions.
3. Garder une condition explicite avant la fusion
Le compte rendu indique que les constats des agents de revue restent visibles dans le trail tant qu’il est ouvert. Les constats doivent être résolus ou fermés avant la fusion ; des Gates configurables au niveau du dépôt peuvent aussi définir les conditions d’approbation. Ce sont les éléments du flux qui relient l’évaluation à une décision de merge, plutôt que de laisser un score jouer seul le rôle de feu vert.
Pour une équipe qui étudie ce type d’organisation, une séquence de lecture prudente serait :
- Relier le trail à une demande identifiable, avec un périmètre compréhensible.
- Examiner les changements poussés et la justification de chaque évaluation, pas seulement le score mis en avant.
- Suivre les constats encore ouverts, les corrections apportées et les résultats des exécutions successives.
- Vérifier que les conditions configurées pour la fusion reflètent les contrôles que l’équipe entend réellement imposer.
- Conserver une décision humaine lorsque le contexte ou le risque exige un jugement qui ne se réduit pas aux évaluations affichées.
Cette chronologie est une grille de lecture du mécanisme décrit, pas un protocole testé sur Entire. Elle permet de distinguer trois choses souvent confondues : l’agent a produit une modification, un évaluateur a formulé des signaux, et les conditions de fusion ont été satisfaites. Les confondre ferait passer une étape d’automatisation pour une preuve complète.
4. Rechercher le « pourquoi » au-delà du diff
La mémoire continue est l’autre pièce importante de la proposition. InfoQ décrit deux outils open source : entire-graph construit une carte pré-calculée du dépôt, incluant notamment des recherches de code classées, des définitions, des appelants, des types et des routes ; entire-brain associe cette carte aux sessions précédentes des agents et aux informations consignées dans l’historique Git. L’objectif annoncé est de permettre aux agents de réutiliser ce contexte entre les sessions, plutôt que de repartir de zéro.
Cette mémoire vise un problème familier aux équipes : un diff montre ce qui a changé, mais pas toujours la raison du changement. Si le contexte pertinent se perd entre une demande, une session d’agent et une autre, les personnes qui reprennent le travail doivent reconstituer l’intention. Pour compléter cette piste côté processus, le journal des interventions d’IA dans un dépôt traite de la traçabilité des décisions et des actions dans un dépôt. Les deux sujets se rejoignent sur la continuité, mais un journal et une mémoire destinée à fournir du contexte à des agents ne sont pas nécessairement le même dispositif.
5. Séparer les caractéristiques décrites des preuves disponibles
InfoQ rapporte aussi qu’Entire repose sur une architecture distribuée et permettrait des pushes jusqu’à 89 fois plus rapides que GitHub. Le compte rendu ne donne pas, dans les éléments disponibles ici, le protocole, les charges comparées ni les conditions de cette mesure. Il faut donc traiter ce chiffre comme une performance rapportée, et non comme un résultat transposable à n’importe quel dépôt ou workflow.
De même, la présence de scores, de Gates et d’une mémoire persistante décrit une organisation possible du travail ; elle ne démontre pas que les constats sont toujours pertinents, que les erreurs sont éliminées ou qu’un agent comprend correctement l’intention du projet. Avant d’évaluer une forge de ce type, une équipe devrait notamment clarifier les critères des évaluations, les modalités de fermeture des constats et la façon dont les changements restent examinables par les personnes responsables. Le compte rendu mentionne la configuration des agents d’évaluation par l’interface d’Entire ou par un fichier JSON au niveau du dépôt, mais ne donne pas ici de résultats d’essai indépendants permettant d’en juger l’efficacité.
Enfin, la description d’InfoQ présente une architecture et des fonctions, mais ne suffit pas à établir leur disponibilité actuelle ni leurs conditions d’accès. Pour un développeur, la question utile n’est donc pas seulement de savoir si une forge parle le langage des agents : c’est de vérifier si son fil de travail rend les itérations compréhensibles, si ses règles de fusion restent explicites et si les preuves disponibles permettent à l’équipe de garder la maîtrise de la revue.
Comment citer
Citez l’URL canonique, l’auteur et la date de mise à jour. Distinguez nos analyses des affirmations de fournisseurs.
Julien Morel. (2026). Forge Git pour agents IA : suivre les évaluations avant de fusionner. IA News Dev. https://ianewsdev.com/forge-git-agents-ia-evaluations-fusion/ (consulté le 2026-11-10).
comment votre équipe suit-elle les itérations d’un agent de code avant d’accepter une fusion ?
Publié dans la discussion