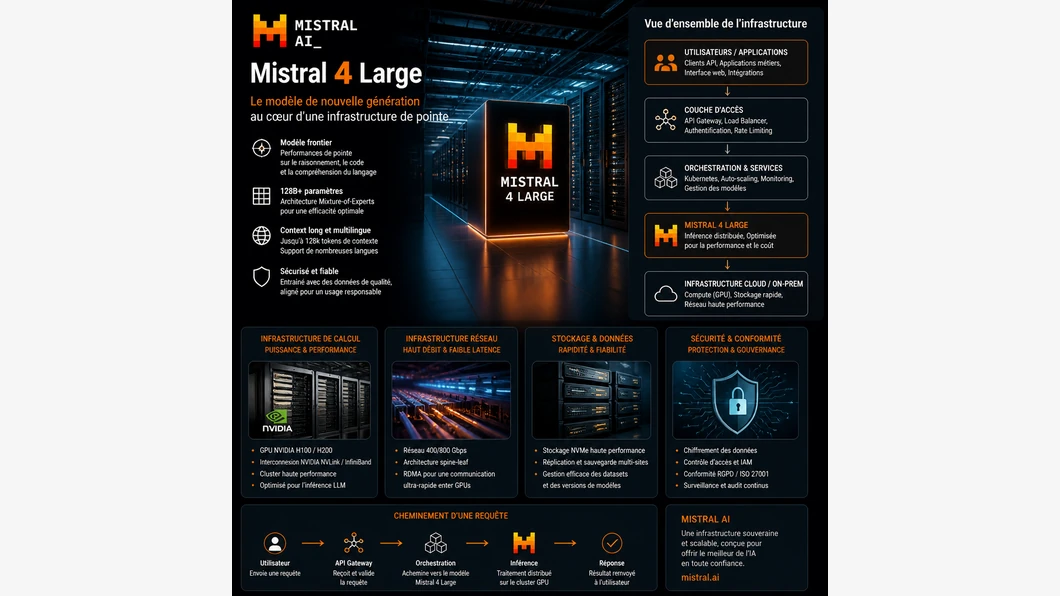
Mistral Large 4 est annoncé disponible sous forme de poids sur Hugging Face, en plus de son accès par l’API de Mistral et d’un essai dans Vibe Code. Pour une équipe de développement, la différence importante n’est pas seulement le nombre de paramètres : c’est la possibilité d’envisager une exécution dans son propre environnement. Elle ne garantit toutefois ni un déploiement léger, ni des performances identiques aux résultats annoncés.
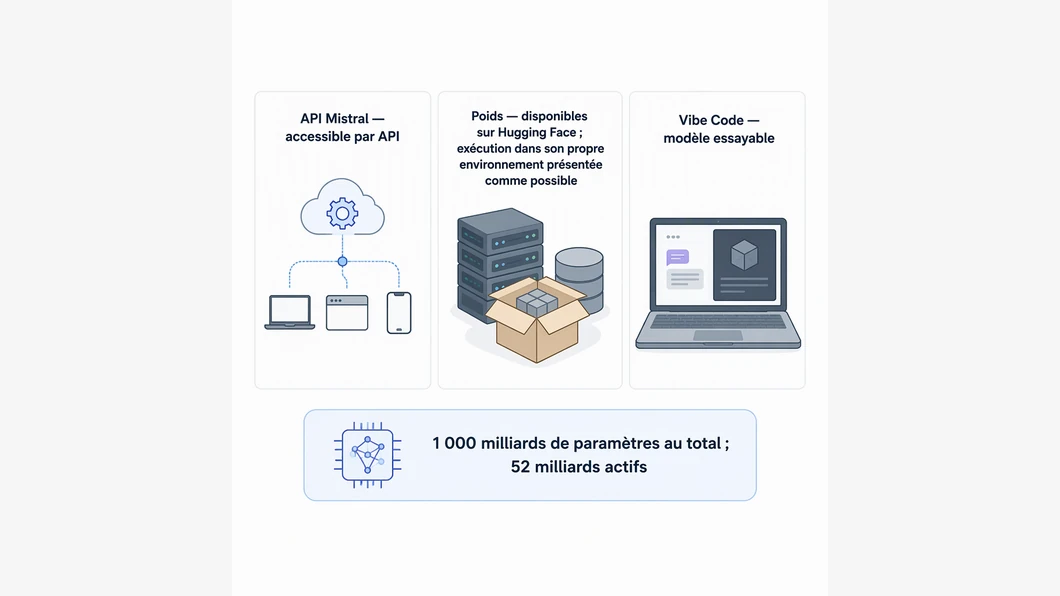
Le compte rendu publié le 30 octobre par Le Monde Informatique indique que Large 4 compte 1 000 milliards de paramètres, dont 52 milliards actifs. Il rapporte aussi que le modèle a reçu trois semaines supplémentaires d’entraînement par renforcement et que Mistral a ajouté trois niveaux de raisonnement : faible, moyen et élevé. Ces éléments décrivent le modèle présenté, pas une mesure indépendante de ce qu’il donnera dans un dépôt ou une chaîne de développement donnée.
Trois voies d’accès, trois questions différentes
La publication des poids élargit le choix de mise à disposition. Elle ne rend pas les trois voies interchangeables : une équipe qui veut examiner une capacité, intégrer un service et héberger un modèle répond à des besoins distincts.
| Voie | Ce que les sources indiquent | Question à trancher côté développement |
|---|---|---|
| API Mistral | Large 4 est accessible par l’API de Mistral. | Le service répond-il aux contraintes d’intégration et d’exploitation du projet ? |
| Poids sur Hugging Face | Le compte rendu du 30 octobre indique que les poids sont mis à disposition ; Mistral présente cette option comme permettant une exécution dans son propre environnement. | L’équipe dispose-t-elle des ressources et des compétences nécessaires pour opérer le modèle ? |
| Vibe Code | Le modèle peut y être essayé. | Un essai dans cet outil répond-il au besoin, ou faut-il évaluer une intégration distincte ? |
Le tableau distingue les informations rapportées des décisions encore propres à chaque équipe. Les sources ne donnent pas ici de configuration matérielle recommandée, de coût d’auto-hébergement ni de procédure détaillée d’installation. On ne peut donc pas déduire du seul accès aux poids que l’exploitation sera simple ou adaptée à toute infrastructure.
Pour cadrer cette décision, il est utile de séparer trois étapes : vérifier l’accès voulu, évaluer les contraintes d’exploitation, puis comparer le comportement du modèle sur des tâches représentatives. Les repères pour interpréter les benchmarks de code de Large 4 complètent cette question de déploiement : un score publié et une décision d’intégration ne mesurent pas la même chose. Pour replacer l’option d’hébergement dans une réflexion plus large, la comparaison entre IA locale et IA cloud pour développer traite les arbitrages généraux sans supposer qu’un modèle particulier convient à chaque équipe.
Ce que les résultats annoncés permettent — et ne permettent pas — de conclure
Mistral met en avant des résultats en programmation agentique. Le compte rendu du Monde Informatique rapporte que, sur Terminal-Bench 4.0, un benchmark d’agents capables d’effectuer des opérations de programmation dans un terminal, le score annoncé pour Large 4 serait passé de 28 % à 41 %, au niveau de GLM-5.3. L’article mentionne aussi une consommation moyenne de jetons inférieure de 47 % par tâche face à GLM-5.3, selon Mistral. Ces données sont attribuées à l’entreprise dans le compte rendu : elles ne constituent pas un essai reproductible sur le dépôt d’une équipe.
La prudence compte aussi pour la cybersécurité. Mistral met en avant des capacités d’analyse du code et de détection de menaces, ainsi qu’un taux de refus annoncé face à des demandes cyber malveillantes. Ces indications ne suffisent pas à valider un usage défensif en production : les besoins, les données, les autorisations et les critères de réussite doivent être évalués dans le contexte réel. Une capacité à traiter des tâches de sécurité ne remplace ni une revue humaine ni les contrôles habituels du logiciel.
Dans un article publié le 7 octobre, Abondance signalait que la plupart des tests alors présentés étaient réalisés en interne ou commandés par Mistral, et qu’aucune évaluation indépendante complète n’avait encore été publiée sur cette préversion. Cette remarque porte sur les évaluations rapportées à cette date ; elle invite à distinguer les déclarations de l’éditeur d’une comparaison indépendante, plutôt qu’à écarter d’emblée les résultats.
Une liste de vérifications avant de choisir l’auto-hébergement
- Préciser le cas d’usage. Définir les tâches de développement visées : assistance sur du code, opérations agentiques dans un terminal ou analyse de code liée à la sécurité. Ne pas supposer qu’un résultat sur un benchmark représente tous ces usages.
- Choisir la voie à évaluer. L’API, l’accès aux poids et l’essai dans Vibe Code ne répondent pas à la même question. Documenter laquelle est réellement envisagée avant de comparer les résultats.
- Vérifier les conditions d’exploitation. Les poids sont publiés sous la Mistral Ecosystem Open-Weight License, décrite par Le Monde Informatique comme dérivée de la licence MIT et encadrant notamment la redistribution et l’exploitation commerciale. Lire les conditions applicables au projet au lieu de déduire les droits du seul terme « open weight ».
- Préparer une évaluation interne. Retenir des tâches représentatives, conserver les mêmes consignes et critères entre solutions, puis examiner les sorties, les erreurs et le travail de vérification nécessaire. Aucun résultat de ce type n’est fourni ici pour un dépôt particulier.
- Estimer la capacité d’exploitation. Le nombre total de paramètres donne une indication de l’échelle du modèle, mais les informations capturées ne précisent pas la configuration nécessaire pour le faire tourner. Obtenir les détails techniques avant de bâtir un budget ou un plan de déploiement.
Un scénario hypothétique pour éviter le faux raccourci
Imaginons une équipe qui souhaite tester un agent de code sans transmettre certains éléments de son projet à un service distant. La publication des poids rend l’option d’un environnement contrôlé pertinente à examiner. Mais l’équipe ne peut pas conclure, à partir de cette seule possibilité, que Large 4 fonctionnera sur son infrastructure, que sa licence correspond à son usage ou que l’agent produira de meilleurs changements. Elle doit d’abord confirmer les conditions d’exploitation, puis conduire une évaluation adaptée à ses tâches. Ce scénario est une illustration, pas le récit d’un test exécuté.
La distinction à retenir est simple : accès aux poids, capacité de déploiement et valeur pour un workflow sont trois décisions successives. Le compte rendu du 30 octobre documente une nouvelle voie d’accès et des capacités revendiquées par Mistral ; il ne fournit pas de recette d’installation ni de preuve de performance sur un environnement développeur précis. Les équipes peuvent donc traiter l’auto-hébergement comme une option à instruire, sans le confondre avec une intégration prête à l’emploi.
Comment citer
Citez l’URL canonique, l’auteur et la date de mise à jour. Distinguez nos analyses des affirmations de fournisseurs.
Julien Morel. (2026). Mistral Large 4 en auto-hébergement : ce que les poids ouverts changent pour les développeurs. IA News Dev. https://ianewsdev.com/mistral-large-4-auto-hebergement-developpeurs/ (consulté le 2026-11-03).
quels critères vous feraient choisir les poids ouverts plutôt qu’un accès par API pour un modèle utilisé en développement ?
Publié dans la discussion