Depuis le 16 novembre 2026, les requêtes vers les modèles de langage des Inference Providers de Hugging Face passent par le routeur d’OpenRouter. Le changement vise notamment les modèles open-weight disponibles sur le Hub : un même jeton Hugging Face peut les appeler par une API commune, tandis que le routeur sélectionne un fournisseur pour chaque requête. Selon l’annonce de Hugging Face sur son partenariat avec OpenRouter, le code existant reste inchangé. En revanche, la facturation et la gestion des clés fournisseur évoluent.
Pour une équipe qui utilise déjà ces services, la question pratique n’est donc pas seulement de savoir si les modèles sont accessibles. Il faut aussi vérifier qui reçoit chaque requête, comment le routage reprend après un échec et quelles conséquences cette nouvelle couche a sur les clés et le suivi des coûts.
Un point d’accès commun, avec un fournisseur choisi à chaque appel
Hugging Face indique que les modèles open-weight présents sur son Hub peuvent être appelés avec un jeton Hugging Face dès lors qu’un fournisseur les sert. OpenRouter choisit alors un fournisseur en fonction de mesures de prix, de vitesse et de fiabilité. Les requêtes de langage passent désormais par ce routeur, sans nécessiter de modification du code selon l’annonce.
Cette compatibilité s’étend aux API Chat Completions et Responses d’OpenAI ainsi qu’à l’API Messages d’Anthropic pour les modèles de conversation, quel que soit le fournisseur en arrière-plan. Hugging Face mentionne aussi des guides de configuration pour Claude Code, Codex, OpenCode, Pi et Hermes Agent. Ce sont des moyens de configurer l’accès, pas la preuve que chaque agent ou SDK a été testé indépendamment par le site.
La distinction compte : l’interface d’appel peut rester stable alors que le fournisseur effectivement sollicité change. Le développeur gagne une couche de routage, mais doit comprendre ses règles et consulter les informations d’utilisation plutôt que supposer qu’un identifiant de modèle fixe toujours le même opérateur.
Ce qui se passe quand un fournisseur ralentit ou échoue
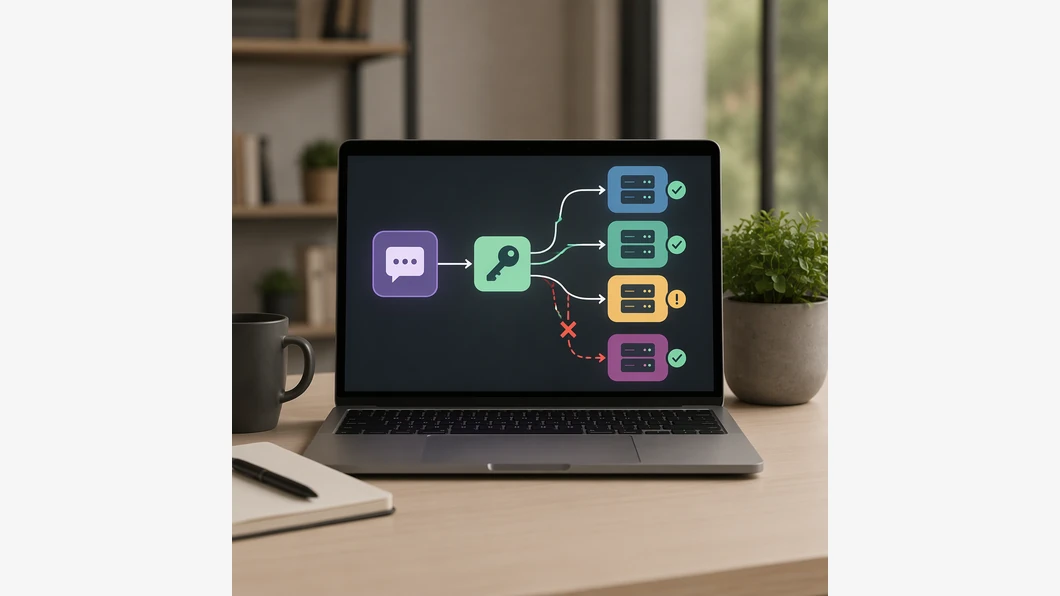
Hugging Face décrit une reprise automatique : si un fournisseur ralentit ou échoue, le trafic peut être dirigé ailleurs et une tentative en échec peut être rejouée auprès du fournisseur suivant dans le même appel. Avant ce changement, la plateforme sélectionnait un fournisseur et renvoyait son erreur en cas d’échec. Le mécanisme annoncé peut donc réduire la dépendance à une seule destination pour une requête donnée, sans garantir qu’un appel réussira dans tous les cas.
L’annonce rapporte, d’après les mesures d’OpenRouter, une baisse de 46 % des erreurs de capacité, une amélioration de 16,9 % du délai avant le premier jeton et une hausse de 16,3 % du débit. Ces chiffres sont attribués aux mesures du routeur : ils ne constituent pas une comparaison indépendante ni une promesse de performance pour chaque application ou charge de travail.
Le routage prend également en compte le cache de prompt : une conversation reste auprès du fournisseur qui détient ce cache. Pour rendre la session explicite, Hugging Face recommande d’envoyer un UUID stable par conversation dans l’en-tête X-HF-Session-Id. Les équipes qui suivent la latence ou les coûts devraient donc vérifier les destinations réellement utilisées et la stabilité de l’identifiant de session, plutôt que d’évaluer uniquement le nom du modèle.
La conséquence à anticiper : les clés fournisseur personnelles ne passent plus
Le changement opérationnel le plus direct concerne les clés. Les requêtes vers les modèles de langage passent par OpenRouter et sont facturées au compte ou à l’organisation Hugging Face. L’annonce précise qu’il n’est donc plus possible d’utiliser sa propre clé API fournisseur pour ces modèles dans ce parcours. Les clés personnalisées pour les fournisseurs d’image et de vidéo continuent, elles, de fonctionner.
La tarification annoncée ne change pas : le prix du fournisseur est porté sur la facture Hugging Face, sans marge ajoutée par Hugging Face. Les utilisateurs PRO disposent de 2 dollars de crédits mensuels ; les organisations Team et Enterprise reçoivent 2 dollars par siège. Ces crédits ne doivent pas être confondus avec une remise générale sur chaque requête.
Pour choisir une destination, Hugging Face indique qu’on peut utiliser un suffixe de fournisseur dans l’identifiant du modèle ou désactiver certains fournisseurs dans les paramètres. Les onglets Providers et Metrics des pages de modèles exposent des informations sur les fournisseurs, notamment prix, vitesse et disponibilité sur les dernières 24 heures. L’aperçu d’utilisation ventile aussi les dépenses par fournisseur. Ce sont des points de contrôle utiles avant de faire évoluer une intégration, notamment si une organisation veut exclure certains opérateurs.
Un scénario concret pour préparer la migration
Imaginons, à titre hypothétique, un service interne qui appelle déjà un modèle de langage via Hugging Face et stocke une clé fournisseur dans sa configuration. Sans changer l’appel applicatif, l’équipe doit tout de même examiner le chemin de facturation et retirer toute dépendance à cette clé pour les modèles de langage via Inference Providers. Elle peut ensuite contrôler les fournisseurs autorisés, observer la ventilation des appels et vérifier que les conversations réutilisent un identifiant de session stable si le cache de prompt est important.
Ce scénario n’est pas un test exécuté : il traduit les changements décrits par l’annonce en vérifications de déploiement. Pour cadrer séparément les dépenses liées aux outils d’IA, voir aussi notre méthode de calcul du budget d’une équipe.
Chronologie : distinguer le changement en place des étapes annoncées
| Étape | Ce que l’annonce indique | Conséquence pour l’équipe |
|---|---|---|
| Changement présenté le 16 novembre 2026 | Les requêtes vers les modèles de langage passent par le routeur OpenRouter ; le code reste identique. | Examiner le routage et les clés fournisseur utilisées. |
| Usage après le changement | Reprise possible vers un autre fournisseur, options de sélection ou d’exclusion, suivi par fournisseur. | Vérifier les paramètres d’organisation, les sessions et la ventilation des coûts. |
| Étapes suivantes mentionnées | Connexion d’un compte OpenRouter à Hugging Face et routage d’autres tâches. | Ne pas traiter ces évolutions futures comme déjà disponibles. |
Le périmètre est important : l’annonce précise que la génération d’images, de vidéos et d’audio continue de fonctionner directement via Hugging Face Inference Providers, sans passer par OpenRouter. Le partenariat présenté concerne donc ici les requêtes aux modèles de langage, et non une bascule générale de toutes les modalités.
Ce qu’il faut retenir avant de modifier une intégration
Pour un développeur, l’intérêt immédiat est un accès commun à des modèles servis par différents fournisseurs, avec sélection et reprise annoncées sans changement de code. Le compromis est une dépendance accrue au compte Hugging Face pour la facturation des modèles de langage et l’impossibilité d’utiliser sa clé fournisseur personnelle dans ce parcours. Les réglages de routage, les métriques par fournisseur et la gestion des sessions deviennent donc des éléments à vérifier dans l’exploitation.
Enfin, la page annonce un partenariat dont certaines étapes restent présentées comme à venir. Les chiffres de routage cités sont ceux d’OpenRouter, et les résultats réels dépendront du modèle, du fournisseur et de la charge. Une intégration stable ne dispense pas de contrôler ces paramètres avant de généraliser l’usage.
Comment citer
Citez l’URL canonique, l’auteur et la date de mise à jour. Distinguez nos analyses des affirmations de fournisseurs.
Julien Morel. (2026). Hugging Face et OpenRouter : ce qui change dans l’appel des modèles open-weight. IA News Dev. https://ianewsdev.com/hugging-face-openrouter-routage-modeles-open-weight/ (consulté le 2026-11-17).
dans une intégration de modèles, quel point de contrôle du routage ou de la facturation vous semble le plus important ?
Publié dans la discussion