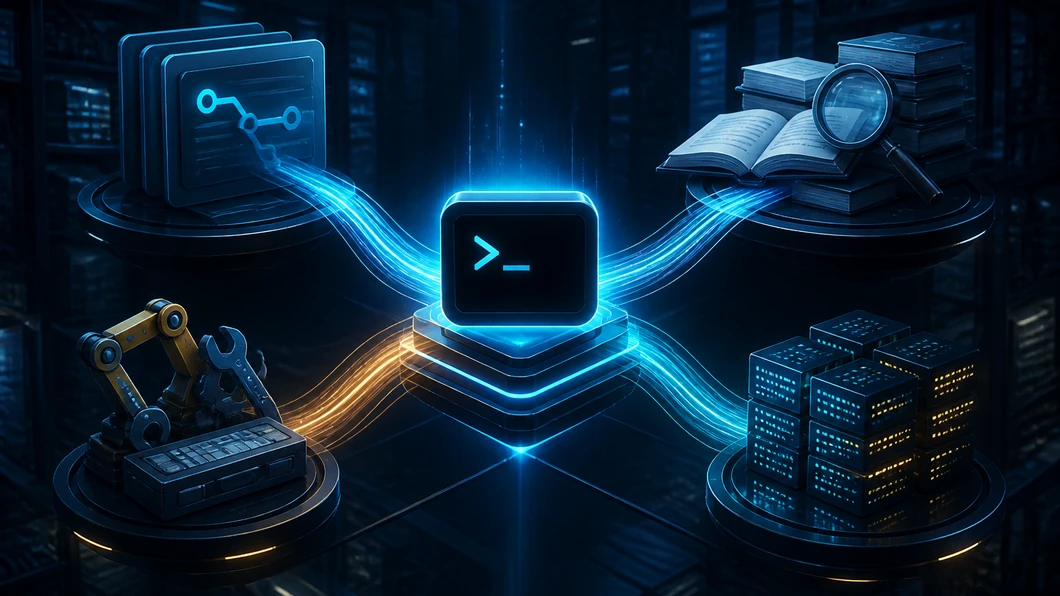
Un agent de code peut disposer d’un modèle performant et produire malgré tout un changement difficile à relire. Le problème ne vient pas toujours du prompt. Il vient souvent de l’endroit où l’information est placée : règle permanente, fichier du dépôt, résultat de recherche, état courant récupéré par un outil ou sortie de commande.
Le choix du canal de contexte devient une décision d’architecture. Une convention stable n’a pas besoin d’être recherchée à chaque tâche. À l’inverse, l’état d’un cluster, le contenu d’une pull request ou la version réellement installée ne devrait pas être figé dans un index. Cette distinction évite de confondre mémoire documentaire, accès opérationnel et état instantané.
Les publications récentes consacrées aux agents de développement convergent sur ce point : le contexte utile n’est pas seulement une question de volume. Il faut préserver l’information qui évite à l’agent de refaire du travail, mesurer ce qui a réellement été récupéré et borner les actions qu’il peut déclencher. InfoQ décrit cette approche autour de la recherche sémantique, des outils et des traces, tandis que GitHub distingue les instructions de projet, les skills, la récupération documentaire et l’accès aux outils.
La matrice de décision avant de brancher un nouvel outil
Le bon canal dépend de quatre questions : l’information change-t-elle souvent, doit-elle être appliquée à chaque tâche, faut-il la citer ou l’exécuter, et quel serait le dommage si elle était périmée ? Le tableau ci-dessous sert à cadrer un choix, pas à classer les technologies par popularité.
| Canal de contexte | À utiliser pour | Point fort | Risque principal |
|---|---|---|---|
| Instructions versionnées | Conventions, limites, critères de livraison | Lisibles et stables | Devenir trop longues ou contradictoires |
| Recherche à la demande | Documentation, décisions, exemples et historique | Ne charger que le contexte pertinent | Retourner des passages périmés ou mal découpés |
| Outil interrogé en direct | État courant, tests, tickets, branches et permissions | Accéder à une donnée actualisée | Élargir l’autorité ou exposer des données sensibles |
| Index du dépôt | Relations entre fichiers, symboles et dépendances | Réduire la recherche manuelle dans un grand codebase | Donner une vision incomplète si l’index dérive |
1. Instructions : le contrat de travail de l’agent
Les instructions versionnées sont adaptées à ce qui doit rester vrai d’une tâche à l’autre : conventions de nommage, commandes autorisées, format attendu d’une pull request, règles de test ou conditions d’escalade. Elles sont utiles parce qu’un développeur peut les relire et les corriger sans dépendre d’un moteur de recherche.
Ce canal ne doit toutefois pas devenir un manuel exhaustif. Une règle permanente doit être courte, testable et rattachée à un périmètre clair. Une longue liste de préférences augmente le risque de conflit avec la demande courante et consomme du contexte à chaque tour. Les instructions expliquent le cadre ; elles ne remplacent ni les fichiers du dépôt ni la vérification de l’état réel.
2. Recherche à la demande : pour les connaissances qui vieillissent
La recherche sémantique convient aux informations qui existent déjà mais ne méritent pas d’être injectées systématiquement : décision d’architecture, discussion de pull request, procédure d’exploitation ou exemple de migration. InfoQ rapporte une recommandation particulièrement concrète : découper les sources en unités autonomes, conserver leurs métadonnées et mettre à jour l’index, y compris lors des suppressions. Une information ancienne peut être plus dangereuse qu’une absence de réponse si elle paraît certaine.
La recherche doit aussi rester mesurable. Il faut pouvoir retrouver les passages renvoyés pour une demande donnée, vérifier leur date et comprendre pourquoi ils ont été sélectionnés. Si l’agent reçoit des dizaines de fragments sans priorité claire, le problème vient peut-être du découpage, des métadonnées ou du filtre de fraîcheur, pas du modèle.
3. Outils : quand le contexte est en réalité une action
Un outil est préférable lorsque l’agent doit connaître un état qui change : branche courante, résultat d’un test, ticket ouvert, configuration d’un environnement ou permission de l’utilisateur. Ce type d’information ne devrait pas être traité comme un document permanent. Il faut l’obtenir au moment où la décision est prise.
Le même canal peut cependant faire passer l’agent de la lecture à l’action. La description de l’outil, ses paramètres, ses erreurs et ses permissions deviennent donc une partie du context engineering. Un outil trop large donne un contexte difficile à interpréter et une autorité difficile à limiter. Un outil étroit, avec une sortie structurée et une validation explicite, facilite la revue.
Le principe est simple : donner à l’agent un accès direct à l’état courant, mais ne pas lui donner automatiquement le droit de le modifier. Les opérations destructrices, externes ou difficiles à annuler doivent rester séparées des opérations d’observation.
4. Index du dépôt : utile pour naviguer, insuffisant pour décider
Un index de code aide l’agent à retrouver des symboles, des références et des fichiers liés dans un dépôt volumineux. GitHub a récemment documenté l’intérêt d’un index de code complet pour accélérer l’intelligence de code dans les grands dépôts C++, tandis que son retour d’expérience sur l’efficacité des agents insiste sur un autre principe : réduire le bruit sans retirer l’information dont la tâche dépend.
L’index ne constitue pas une preuve de comportement. Il ne remplace pas l’exécution des tests, la lecture du diff ou la vérification de la version réellement utilisée. Il sert à trouver le bon périmètre plus vite. Pour une migration ou une correction de sécurité, l’agent doit ensuite confirmer les hypothèses avec les fichiers actuels et les commandes autorisées.
Quelle combinaison choisir selon le cas d’usage ?
Pour une correction locale et bien spécifiée, combinez des instructions courtes, l’index du dépôt et les tests. Pour une question d’architecture, ajoutez une recherche documentaire avec métadonnées de fraîcheur. Pour un diagnostic d’incident, privilégiez les outils qui interrogent l’état courant et conservez les traces de la session. Pour une modification qui touche des permissions ou des données externes, séparez explicitement observation, proposition et exécution.
Cette combinaison est plus robuste qu’un unique « contexte complet ». Elle évite de charger tout le dépôt, toutes les conversations et tous les outils au début de chaque tâche. Elle permet aussi de comprendre ce qui a réellement influencé une décision lorsque le résultat doit être relu.
Checklist de conception
- Écrire dans les instructions uniquement les règles stables et vérifiables.
- Ajouter une date, une équipe ou une version aux documents récupérables.
- Conserver les suppressions et les changements de source dans le cycle d’indexation.
- Réserver les outils en direct aux informations qui changent réellement.
- Séparer les outils de lecture des outils de modification.
- Limiter chaque outil à un périmètre, une identité et des paramètres compréhensibles.
- Tracer les sources récupérées, les appels d’outils et les décisions de validation.
- Tester un changement de contexte comme un changement de workflow, sans prétendre à un gain avant mesure.
Le choix ne se résume donc pas à « plus de contexte » ou « moins de tokens ». Il s’agit de placer chaque information dans le canal qui correspond à sa durée de vie, à son niveau de confiance et à son pouvoir d’action. Les équipes qui commencent par cette séparation obtiennent un agent plus facile à contrôler, à diagnostiquer et à faire évoluer.
Pour cadrer les données sensibles avant toute connexion, voir aussi le périmètre d’un sandbox documentaire IA. Pour organiser les preuves d’exécution, la page sur l’observabilité des agents IA complète cette matrice.
Comment citer
Citez l’URL canonique, l’auteur et la date de mise à jour. Distinguez nos analyses des affirmations de fournisseurs.
Julien Morel. (2026). Context engineering pour agents de code : quel canal choisir selon la tâche ?. IA News Dev. https://ianewsdev.com/context-engineering-agents-code-canaux/ (consulté le 2026-09-24).
quel canal de contexte vous paraît le plus difficile à maintenir dans vos agents de code ?
Publié dans la discussion