Scout est un modèle entraîné pour enquêter sur des problèmes de production, et non un agent de réparation autonome. Le compte rendu d’InfoQ du 29 octobre 2026 indique qu’il est intégré à Bits Investigation, le produit SRE de Datadog : il peut examiner une alerte, parcourir la télémétrie et proposer une cause. À cette date, son accès est décrit comme une préversion fermée pour des ingénieurs Datadog et un petit nombre de clients. Le compte rendu d’InfoQ sur Scout détaille aussi les évaluations et leurs limites.
Pour une équipe SRE, la question utile n’est donc pas seulement de savoir si Scout obtient un bon score. Il faut distinguer ce que mesurent les tests, ce que signifie le coût annoncé, et ce qui reste à vérifier avant de s’appuyer sur ses diagnostics pendant un incident.
1. Situer Scout dans l’enquête sur un incident
Le rôle décrit est celui d’un premier intervenant logiciel : recueillir des éléments et proposer une cause probable avant ou pendant l’intervention d’un ingénieur. Les outils d’investigation mentionnés couvrent les journaux, les métriques et les traces, ainsi que l’inspection du code, des déploiements et des feature flags. Cette portée compte : une réponse dépend de ce que l’agent peut consulter et des indices disponibles, pas uniquement de la qualité de son modèle.
Scout repose sur GLM-5.3 Flash, puis a été post-entraîné par apprentissage par renforcement. D’après l’article d’InfoQ, les exercices d’entraînement sont des simulations d’incidents construits à partir de motifs de cas historiques. Datadog indique qu’ils ne contiennent pas de données clients. Les simulations donnent au modèle une alerte, de la télémétrie interrogeable et une cause connue : cela fournit un cadre d’apprentissage, mais ne constitue pas en soi une validation indépendante sur les incidents d’une autre organisation.
2. Lire les deux évaluations sans confondre leurs scores
AlertEval compare le compte rendu de Scout à une explication rédigée par un expert, à partir d’alertes réelles, de télémétrie archivée et d’explications préparées par des ingénieurs Datadog. Un évaluateur fondé sur un modèle de langage récompense les correspondances sur la cause immédiate et la cause sous-jacente ; les contradictions et les affirmations sans preuve font baisser la note. Le score va de zéro à cent, mais Datadog précise qu’il ne représente pas le pourcentage d’incidents résolus.
InfoQ rapporte que Scout medium obtient un score similaire à GPT-6.1 Sol high et Claude Opus 5.5 high sur AlertEval. Le compte rendu rapporte aussi, au réglage xhigh, une correspondance avec Claude Fable 5.1 xhigh pour un quart du coût estimé. Ces comparaisons donnent un repère sur ce benchmark et sur l’estimation de coût annoncée ; elles ne démontrent ni une équivalence générale des modèles ni une baisse de facture identique dans chaque environnement.
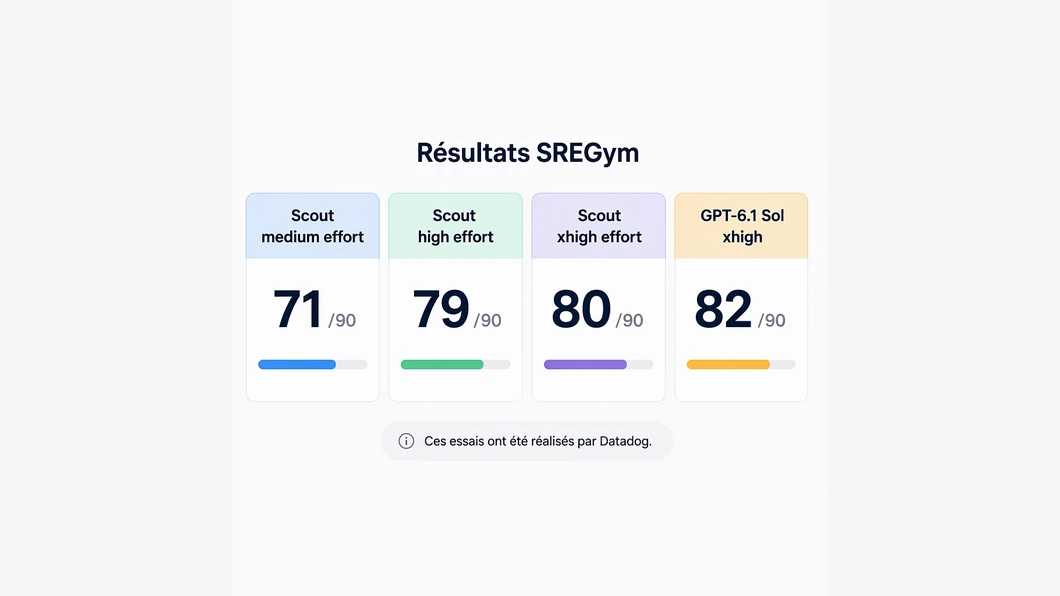
La seconde évaluation, sur SREGym, porte sur un ensemble public de 90 fautes. Les résultats rapportés par InfoQ sont les suivants :
| Configuration évaluée | Cas résolus sur SREGym |
|---|---|
| Scout medium effort | 71 sur 90 |
| Scout high effort | 79 sur 90 |
| Scout xhigh effort | 80 sur 90 |
| GPT-6.1 Sol xhigh | 82 sur 90 |
Ces essais ont été réalisés par Datadog, y compris les exécutions des modèles de comparaison plus récents, précise InfoQ. Des résultats indépendants aideraient à apprécier la portée de l’écart observé. Le nombre de cas résolus est un résultat sur ce jeu de tests précis, pas une garantie de résolution sur les incidents rencontrés par une équipe.
3. Examiner le coût avec le périmètre du test
Le motif économique rapporté est lié au fonctionnement d’une enquête : Bits peut devoir lancer plusieurs appels au modèle, examiner les résultats puis décider quoi vérifier ensuite. Datadog présente le coût des modèles généralistes comme un obstacle à leur utilisation sur chaque alerte. InfoQ rapporte une estimation d’inférence de trois à huit fois plus basse pour Scout medium dans la comparaison citée. Aucun prix absolu n’est donné dans le compte rendu ; les chiffres sont relatifs au coût d’une investigation Scout medium.
Il faut donc éviter de transformer ce ratio en prévision budgétaire. Pour l’évaluer dans un contexte d’équipe, il faudrait au minimum rapprocher le nombre d’investigations envisagé, les niveaux d’effort utilisés et la définition du coût comparé. Les éléments publiés dans le compte rendu ne fournissent pas de prix par incident applicable à une autre organisation. Le choix porte aussi sur le niveau de preuve accessible à l’ingénieur : un diagnostic bref n’est exploitable que si les éléments qui le soutiennent peuvent être examinés.
4. Suivre le parcours de l’alerte à la décision
Le flux décrit par InfoQ peut se résumer ainsi, sans confondre proposition de diagnostic et changement en production :
- Une alerte déclenche une investigation dans Bits.
- Scout consulte les éléments disponibles, notamment la télémétrie, et cherche des indices sur la cause.
- Le modèle propose un diagnostic et des actions de récupération possibles.
- Un ingénieur examine la proposition et reste responsable du changement.
La préversion décrite s’arrête avant la réparation automatique : l’article indique que Datadog prévoit d’ajouter d’autres types de défaillance aux simulations et envisage que Bits effectue éventuellement des réparations, mais ne donne pas de date de disponibilité générale pour Scout. Un scénario futur ne doit donc pas être traité comme une capacité déjà accessible.
5. Checklist avant d’évaluer Scout sur vos alertes
- Vérifier l’accès réel au produit : la disponibilité rapportée est une préversion fermée, sans date de disponibilité générale annoncée dans le compte rendu.
- Définir le périmètre des alertes visées et les données de télémétrie que l’enquête pourra exploiter.
- Lire les scores comme des résultats de benchmark : AlertEval mesure la concordance d’explications, tandis que SREGym rapporte des cas résolus sur un jeu de fautes défini.
- Consigner le réglage d’effort et le périmètre du coût comparé ; le ratio annoncé ne donne pas un prix absolu par incident.
- Prévoir une revue humaine du diagnostic et des actions suggérées. Dans la préversion décrite, l’ingénieur reste responsable du changement.
- Demander quelles preuves soutiennent la cause proposée et quelles pistes ont été écartées. La visibilité du raisonnement et des éléments consultés est un enjeu distinct du score final.
Les détails d’entraînement rapportés montrent pourquoi ce dernier contrôle importe. Une récompense fondée uniquement sur la réponse finale aurait encouragé Scout à formuler moins d’affirmations et à arrêter l’enquête plus tôt, sans le rendre meilleur enquêteur. Datadog a ensuite ajusté la récompense pour prendre en compte la justesse, l’exploration et les éléments à l’appui, et a varié certains entraînements en retirant des outils ou en raccourcissant le temps disponible. C’est une indication utile sur les difficultés de conception d’un modèle d’investigation, pas la preuve que toute enquête sera transparente ou complète.
Scout se distingue ainsi par un modèle spécialisé intégré au produit d’observabilité Datadog, avec des résultats publiés sur AlertEval et SREGym et une estimation de coût relative. Les données rapportées fournissent des points de comparaison, mais leur portée reste attachée aux évaluations conduites par Datadog et à une préversion fermée. Pour replacer cet enjeu dans les pratiques de suivi des systèmes agentiques, consultez aussi les traces et métriques à suivre pour observer un agent IA en production.
Comment citer
Citez l’URL canonique, l’auteur et la date de mise à jour. Distinguez nos analyses des affirmations de fournisseurs.
Julien Morel. (2026). Scout de Datadog pour le SRE : ce que ses évaluations permettent de conclure. IA News Dev. https://ianewsdev.com/scout-datadog-evaluations-sre/ (consulté le 2026-11-03).
quels éléments de preuve vous faut-il pour faire confiance à un diagnostic SRE assisté par IA ?
Publié dans la discussion