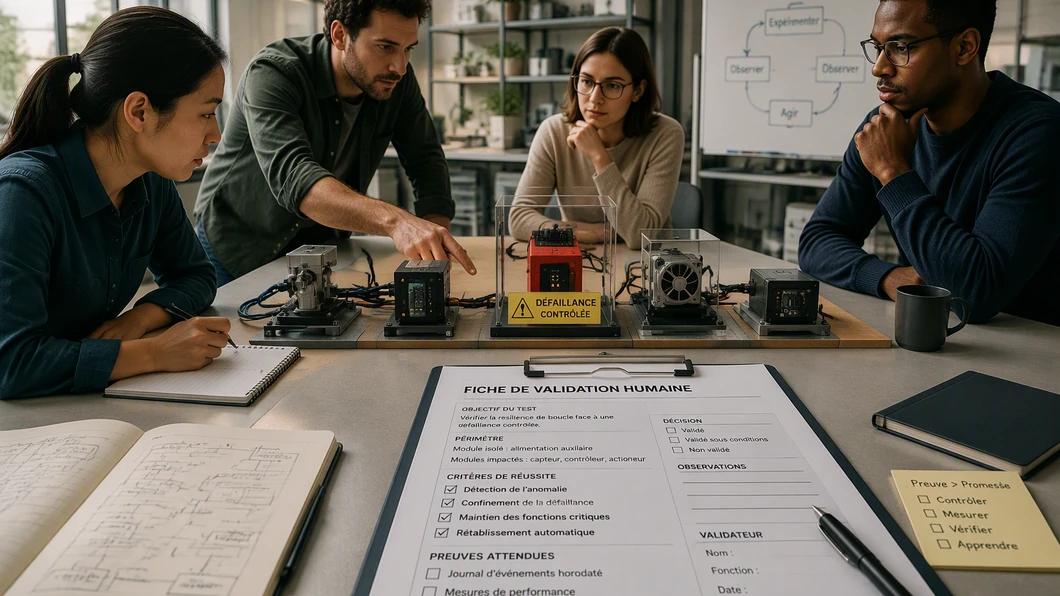
Foresight AI vise un problème concret : transformer des tests de fiabilité en une boucle qui repère un risque, propose une action, puis vérifie le correctif. Dans son article du 11 octobre 2026, InfoQ rapporte que Gremlin a annoncé la disponibilité générale du produit comme module complémentaire de sa plateforme. C’est une annonce rapportée, pas une mesure indépendante de ses performances ni une confirmation de disponibilité actuelle.
Pour une équipe d’ingénierie, la question utile n’est donc pas seulement de savoir si des agents peuvent lancer des expériences. Il faut examiner ce qu’ils proposent, où l’approbation humaine intervient et quelle preuve permet de conclure qu’un changement a réellement amélioré le service.
1. Repérer ce que les agents prennent en charge
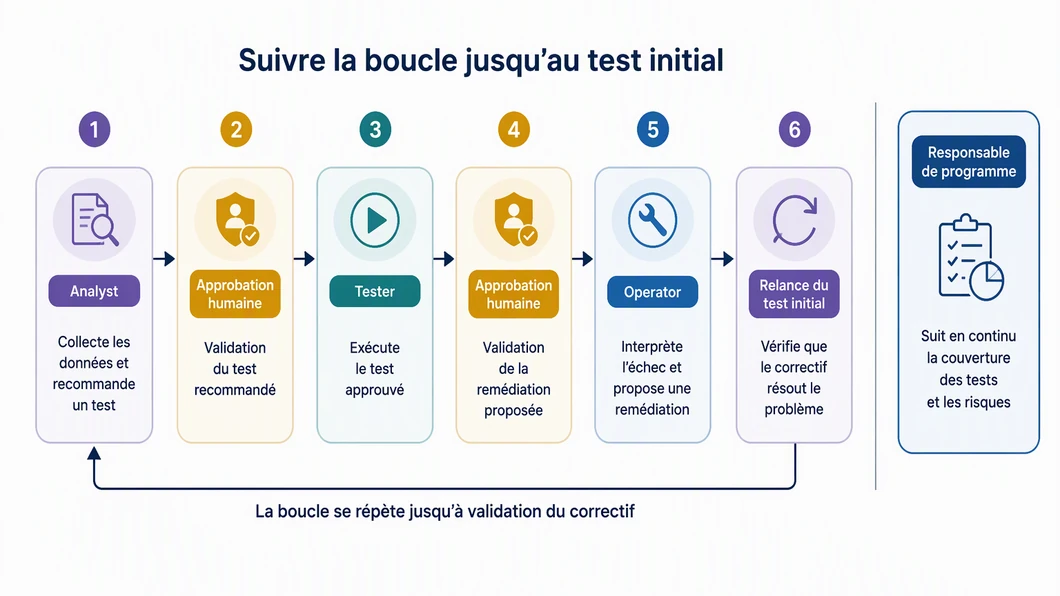
Gremlin présente Foresight AI comme un produit agentique qui analyse les services pour repérer des défaillances potentielles, recommande des changements et relance des tests afin de vérifier qu’un correctif fonctionne. Le travail est réparti entre quatre rôles, plutôt que confié à un agent unique qui prendrait toutes les décisions.
- Analyst rassemble des données sur les services et recommande des tests.
- Tester planifie et exécute les expériences.
- Operator interprète les tests qui échouent et propose des remédiations.
- Un responsable de programme technique suit la couverture des tests, les risques et les engagements entre équipes. InfoQ rapporte aussi que ce rôle peut produire des rapports hebdomadaires et envoyer des mises à jour dans Slack.
Cette répartition aide à poser des questions précises pendant une évaluation : quelles données alimentent une recommandation, qui choisit le test, et comment une proposition de correction est-elle reliée à l’échec qu’elle doit traiter ? Le nombre d’agents ne constitue pas, à lui seul, une preuve de qualité.
2. Examiner la frontière d’approbation
Le contrôle humain est un élément central de la description du produit. Gremlin indique que Foresight AI ne lance ni test ni remédiation sans approbation. L’automatisation décrite porte donc sur l’analyse, la coordination et les répétitions ; l’autorisation d’agir reste du côté de l’équipe.
Cette frontière mérite d’être vérifiée dans le fonctionnement proposé à l’équipe, pas seulement dans une présentation. Avant d’autoriser un essai, demandez ce qui est soumis à approbation, quel contexte accompagne la demande et si la personne qui valide peut comprendre les conséquences de l’expérience. Pour une remédiation, distinguez la recommandation de sa mise en œuvre : une proposition formulée par un agent n’est pas encore un changement validé.
Gremlin décrit aussi sa plateforme comme permettant de planifier des expériences et de contrôler leur « blast radius », c’est-à-dire l’étendue de leurs effets. Pour une équipe, le périmètre autorisé et les conditions d’arrêt font partie du test d’acceptation : un essai dont les limites ne sont pas lisibles ne devient pas sûr simplement parce qu’un agent le pilote.
3. Suivre la boucle jusqu’au test initial
Le point distinctif annoncé est la validation en boucle fermée : lorsqu’un test révèle une faiblesse, le service propose une modification, puis relance le test d’origine pour contrôler le correctif. Pour évaluer ce mécanisme, il est utile de suivre une expérience de bout en bout et de conserver séparément l’échec initial, la modification proposée, la décision humaine et le résultat de la répétition.
- Définir le cas. Notez le comportement à vérifier, le service concerné et le périmètre de l’expérience. Si un test n’a pas de résultat attendu identifiable, une réussite ou un échec risque d’être difficile à interpréter.
- Examiner la recommandation. Vérifiez que l’équipe peut relier les données utilisées au test proposé et comprendre pourquoi il est pertinent pour le risque ciblé.
- Contrôler les autorisations. Repérez les points où une personne doit approuver le lancement d’un test et l’application d’une remédiation.
- Comparer les deux exécutions. Après la correction, vérifiez que la répétition concerne bien le test initial et que son résultat répond à la question posée. Un signal d’alerte devenu silencieux, à lui seul, ne démontre pas qu’un système résiste à une défaillance.
- Conserver la trace. Reliez le résultat, le changement et la décision de l’équipe afin de pouvoir discuter de ce qui a été couvert et de ce qui reste à tester.
Ce protocole est une méthode d’évaluation proposée, pas un essai exécuté sur Foresight AI. Pour compléter le suivi des tests dans une chaîne de livraison, voir aussi l’observabilité des tests IA en CI.
4. Distinguer les données produit des preuves d’efficacité
Selon l’article d’InfoQ, Foresight AI s’appuie sur le Failure Atlas de Gremlin, décrit par l’entreprise comme un historique propriétaire constitué à partir de millions d’expériences d’injection de fautes, menées pendant plus de dix ans sur des dizaines de milliers de systèmes distribués. InfoQ rapporte également que Gremlin affirme ne pas utiliser les données des systèmes pour entraîner un grand modèle de langage : les agents s’appuieraient sur les données de la plateforme et le Failure Atlas, tandis qu’un LLM servirait à rechercher, résumer et expliquer les résultats. Ces éléments décrivent les déclarations de l’entreprise ; ils ne constituent pas une évaluation indépendante de la qualité des recommandations.
InfoQ précise qu’aucune donnée comparative détaillée sur la précision, les taux de faux positifs ou les résultats de bêta n’a été publiée. Cela limite ce qu’un lecteur peut conclure sur la performance du produit à partir de l’annonce. Les scores de fiabilité et les rapports en langage naturel évoqués par Gremlin peuvent aider à rendre les risques et les travaux visibles, mais leur utilité dépendra de ce qu’ils mesurent et de la façon dont l’équipe les interprète.
5. Un scénario hypothétique pour cadrer la revue
Supposons, sans décrire un cas réel, qu’une équipe veuille vérifier le comportement d’un service lorsqu’une dépendance devient indisponible. Elle peut demander à examiner le scénario de défaillance et son périmètre, puis vérifier que la recommandation de test correspond au risque étudié. Si une faiblesse est trouvée, l’équipe examine la remédiation proposée, décide si elle l’accepte et compare le résultat du test répété à celui de l’expérience initiale. À chaque étape, la question est la même : quelle décision appartient à l’agent, laquelle reste à l’ingénieur et quelle trace permet de justifier la conclusion ?
Le scénario ne prouve rien sur les capacités de Foresight AI. Il montre plutôt pourquoi l’évaluation doit porter sur la chaîne complète : une proposition pertinente ne suffit pas si son périmètre est mal compris, et un test réussi ne suffit pas si l’équipe ne sait pas ce qui a changé entre les deux exécutions.
Avant de retenir l’outil
- Vérifier que les recommandations sont compréhensibles et reliées au risque visé.
- Identifier précisément les approbations nécessaires avant un test ou une remédiation.
- Examiner si l’équipe peut retracer l’échec, le changement proposé et le résultat de la répétition.
- Demander quelles données soutiennent les scores et rapports, sans assimiler leur présentation à une preuve comparative.
- Évaluer l’outil sur le périmètre et les critères de décision propres à l’équipe, plutôt que sur la seule promesse d’automatisation.
Foresight AI est présenté comme un moyen de coordonner des vérifications de résilience et d’en répéter une partie. La décision d’adopter ce type de flux dépendra moins du nombre d’agents que de la qualité des preuves disponibles, de la maîtrise des autorisations et de la capacité de l’équipe à interpréter les résultats.
Comment citer
Citez l’URL canonique, l’auteur et la date de mise à jour. Distinguez nos analyses des affirmations de fournisseurs.
Julien Morel. (2026). Foresight AI de Gremlin : évaluer sa boucle de fiabilité sans confondre promesse et preuve. IA News Dev. https://ianewsdev.com/evaluer-foresight-ai-gremlin-fiabilite/ (consulté le 2026-10-20).
quels contrôles vous semblent indispensables avant de laisser un agent proposer ou lancer des tests de résilience ?
Publié dans la discussion