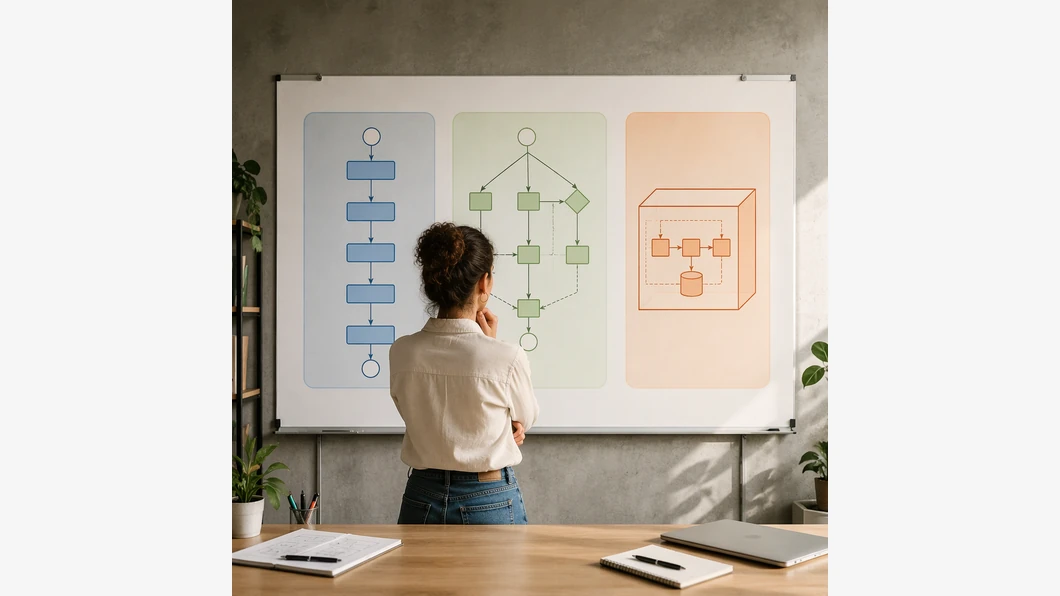
Le choix d’un harness d’agent IA se joue moins sur sa sophistication que sur le type d’échec qu’il doit empêcher ou récupérer. Une chaîne convient à une tâche linéaire et étroite ; un graphe rend visibles les bifurcations et les reprises ; un harness fondé sur l’exécution de code peut vérifier un résultat dans un environnement contrôlé. Chacun ajoute aussi ses propres coûts et risques.
Cette comparaison s’appuie sur les architectures décrites par Karthik Ramgopal dans son article publié par InfoQ sur les harnesses d’agents, notamment des exemples attribués à LinkedIn. Pour compléter la question du choix, une analyse InfoQ des systèmes distribués agentiques décrit les problèmes de qualité de décision et de surveillance qui peuvent persister même lorsque l’infrastructure fonctionne.
Trois formes d’orchestration, trois compromis
| Forme | Contrôle du flux | Atout principal | Limite à surveiller |
|---|---|---|---|
| Chaîne | Étapes linéaires définies à l’avance | Peu d’orchestration, adaptée à une tâche étroite | Une sortie erronée peut contaminer les étapes suivantes |
| Graphe | Nœuds et transitions explicites, avec embranchements possibles | Conditions, état, reprises et validations plus visibles | Les chemins de récupération et cas limites alourdissent le workflow |
| Code exécuté | Le modèle propose du code, exécuté puis vérifié | Tests et résultats exécutables peuvent fournir un retour vérifiable | Sandbox, instrumentation et boucles de reprise ajoutent de la complexité |
Le tableau compare des propriétés de conception, pas des performances mesurées dans un benchmark. Un contrôle explicite ne garantit pas à lui seul une réponse correcte : il indique où placer les validations et ce qu’il faut surveiller.
Repères chronologiques : pourquoi les abstractions se sont étoffées
-
Les chaînes : les premières architectures assemblent des étapes de prompts et d’appels d’outils. Dans l’exemple LinkedIn rapporté par Ramgopal, une chaîne séparait routage, récupération d’informations et génération. La simplicité facilite un premier déploiement, mais le texte produit à chaque étape sert d’entrée à la suivante : sans mécanisme de détection ou de reprise, une erreur en amont peut se propager.
-
Les graphes : quand les tâches exigent des décisions conditionnelles, des reprises ou un état partagé, les nœuds et les transitions rendent le flux plus explicite. L’exemple décrit dans l’article utilise notamment des exécutions conditionnelles, des fallbacks, la gestion d’état et des validations. Cette structure aide à examiner le parcours, mais chaque branche et chaque cas limite demandent une conception et une maintenance supplémentaires.
-
Le code comme moyen d’exécution : plutôt que de faire reposer toute la résolution sur une longue réponse textuelle, le modèle peut générer du code, l’exécuter dans une sandbox et corriger sa proposition à partir des erreurs ou des contrôles. Les tests et assertions rendent certains résultats vérifiables ; ils ne garantissent pas que les critères de test couvrent le besoin réel.
Cette chronologie décrit des options apparues au fil de besoins plus complexes, pas une feuille de route imposant de remplacer toute chaîne par un graphe, puis par du code. Les chaînes restent adaptées à des tâches prévisibles ; les architectures plus élaborées se justifient lorsque leurs contrôles répondent à un risque réel.
Choisir à partir du mode d’échec redouté
Pour une transformation simple ou une synthèse en un nombre limité d’étapes, une chaîne peut rester le choix le plus sobre. La question pratique est alors : comment repérer une sortie invalide avant qu’elle n’alimente l’étape suivante ? Des contrôles de schéma ou de règles métier peuvent borner ce risque sans transformer d’emblée tout le flux en orchestration complexe.
Un graphe devient utile lorsque le parcours dépend de résultats intermédiaires : réorienter une demande, demander une précision, réessayer un appel ou transmettre une tâche à une étape de validation. Ses transitions visibles facilitent l’inspection, mais un graphe trop détaillé peut devenir difficile à maintenir. Il faut donc distinguer les branches qui représentent un vrai choix produit de celles qui ne font qu’encoder des exceptions mal comprises.
Un harness de code est plus pertinent quand la réponse peut être confrontée à un critère exécutable : compilation, test, assertion ou validation sur des données. Dans l’exemple LinkedIn rapporté par l’auteur, un agent traduit une question analytique en SQL et Python, exécute le code sur des données d’exemple puis vérifie des contraintes, dont des contrôles de confidentialité et de gouvernance. Cet exemple est une architecture décrite par son auteur, pas une mesure indépendante de performance ni une garantie transférable à tout projet.
Exécuter le code proposé exige de contrôler l’environnement. La description de Ramgopal associe ce modèle à une sandbox, à la journalisation des sorties et erreurs, à un dispositif de validation et à une boucle de correction. Sans ces éléments, le fait qu’un programme s’exécute ne suffit pas à établir que son résultat est juste ou sûr. Une boucle de reprises doit aussi être bornée : autrement, les tentatives supplémentaires peuvent accroître latence, charge et coût.
Surveiller la qualité, pas seulement la disponibilité
Une réponse d’agent peut se dégrader sans provoquer de panne serveur évidente. L’analyse d’InfoQ sur les systèmes distribués agentiques souligne que la qualité des décisions — choix d’outil, interprétation du contexte ou sélection des sources — peut baisser alors que latence et taux d’erreur restent stables. Elle recommande d’observer les étapes de décision et les résultats d’évaluation, en complément des indicateurs d’infrastructure.
Concrètement, la revue d’un harness peut suivre les outils choisis, les sorties intermédiaires utiles, les validations échouées, les reprises et le recours aux chemins de secours. Les traces doivent être conçues en tenant compte des informations sensibles : voir davantage ne justifie pas de journaliser sans précaution des contenus confidentiels. Pour approfondir cette question de suivi en production, consultez aussi notre article sur les dérives silencieuses des agents IA.
Une règle de décision proportionnée
-
Gardez une chaîne si le flux est linéaire, que les sorties peuvent être contrôlées et qu’une reprise complexe n’est pas nécessaire.
-
Choisissez un graphe si le système doit bifurquer, conserver un état explicite, réessayer ou demander une validation à un moment précis.
-
Envisagez l’exécution de code si la tâche permet des vérifications exécutables et si l’équipe peut isoler, journaliser et borner l’environnement d’exécution.
-
Dans les trois cas, définissez ce qui compte comme réussite, les erreurs qui doivent bloquer la suite et le comportement attendu quand la validation échoue.
La sophistication n’est pas un objectif en soi. Le bon harness est le plus simple qui satisfait les exigences de fiabilité, de vitesse et de coût de la tâche, tout en rendant ses échecs observables et récupérables. Si ces exigences changent, réévaluez l’abstraction à partir des défaillances constatées plutôt que d’ajouter des couches par anticipation.
Comment citer
Citez l’URL canonique, l’auteur et la date de mise à jour. Distinguez nos analyses des affirmations de fournisseurs.
Julien Morel. (2026). Chaîne, graphe ou code : choisir le bon harness pour un agent IA. IA News Dev. https://ianewsdev.com/choisir-harness-agent-ia/ (consulté le 2026-11-03).
dans votre projet, quel type d’échec a réellement justifié de passer d’une chaîne à un graphe ou à l’exécution de code ?
Publié dans la discussion