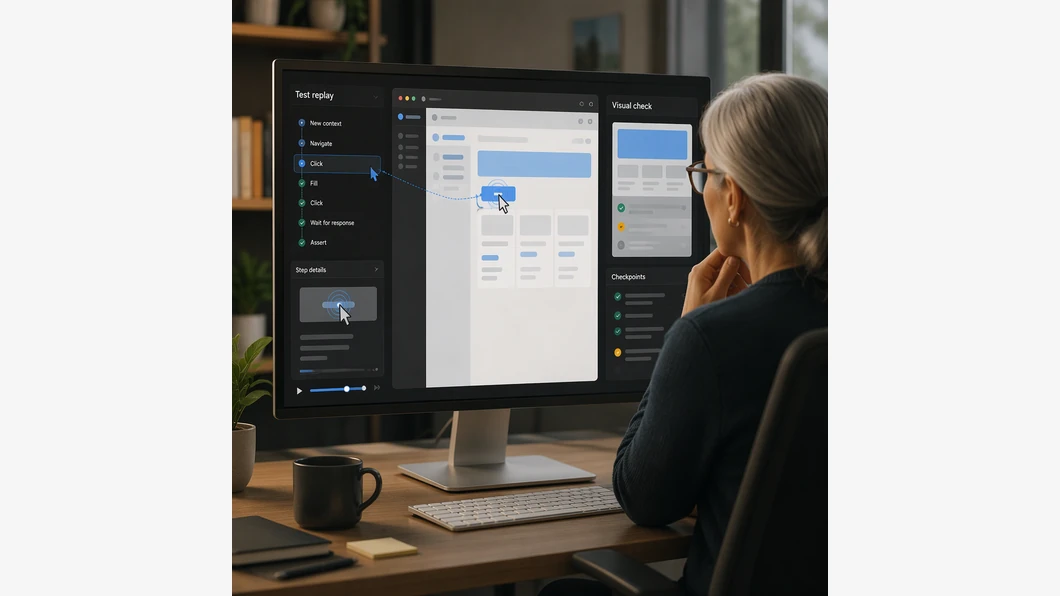
Le compromis proposé par Bug0 QA Agent tient à une séparation précise : un agent explore l’interface lors d’une première exécution, puis certaines actions réussies sont compilées en opérations Playwright et rejouées sans nouvelle inférence. Ce mécanisme peut réduire le recours au modèle pendant les relectures courantes, mais ne transforme pas tous les tests en scripts déterministes : les assertions restent vérifiées par des modèles de vision et les consignes comprenant plusieurs actions repassent par l’agent.
Dans son article du 29 octobre 2026, InfoQ décrit QA Agent comme une bibliothèque Playwright source-available pour les tests de régression de navigateur. L’intérêt pour une équipe n’est donc pas seulement de produire des scénarios en langage naturel : c’est de comprendre quelles parties de leur exécution sont rejouées, lesquelles continuent de dépendre d’une évaluation par modèle et ce qui se passe quand l’interface change.
Un compromis entre scripts fragiles et agent sollicité à chaque étape
Les tests traditionnels peuvent dépendre de détails d’implémentation, comme des classes CSS ou des attributs de test. Quand ces repères évoluent sans que le comportement attendu ait changé, les scripts peuvent nécessiter une maintenance. À l’autre extrême, un agent qui interprète chaque étape à la volée peut être flexible, mais InfoQ relève la latence, les coûts d’API et le caractère non déterministe des actions comme des limites de cette approche. QA Agent cherche à combiner exploration assistée et exécution récurrente plus directe.
Le déroulé décrit commence par des étapes de test déclaratives rédigées en anglais courant dans des spécifications Playwright standard. À la première exécution, l’agent examine l’arbre d’accessibilité et des captures d’écran pour comprendre l’interface et tenter l’action demandée. Quand une étape à action unique réussit, l’interaction est convertie en opérations de navigateur concrètes et conservée dans un cache en mémoire Redis. Lors des passages suivants, Playwright rejoue cette action sans solliciter une nouvelle inférence LLM pour cette étape.
| Approche | Ce qu’elle privilégie | Point de vigilance décrit |
|---|---|---|
| Script de test classique | Des opérations de navigateur explicites et automatisées. | Des sélecteurs ou détails d’interface qui changent peuvent entraîner une maintenance du test. |
| Agent à chaque étape | Une interprétation dynamique de l’interface et des consignes. | Latence, coûts d’API et variabilité des actions sont à prendre en compte. |
| Relecture hybride de Bug0 | Mettre en cache certaines actions simples réussies et les rejouer avec Playwright. | Le cache est limité aux étapes à action unique ; les assertions ne sont pas mises en cache. |
Le cache accélère une partie du parcours, pas toute la vérification
La frontière entre action et assertion est essentielle. Le cache décrit dans l’article concerne les étapes à action unique. Si l’interface change, une action rejouée peut échouer ; Bug0 détecte cette rupture, invalide l’action concernée et relance la boucle multimodale de l’agent au lieu de laisser le cache continuer comme si de rien n’était. En revanche, une consigne complexe comportant plusieurs actions est réexécutée par l’agent à chaque passage.
Les assertions suivent une autre voie : elles ne sont pas mises en cache et sont évaluées par des modèles de vision à chaque exécution. InfoQ indique que Claude et Gemini évaluent indépendamment chaque assertion, et qu’un troisième modèle départage les cas d’égalité. Des modèles vidéo servent aussi à repérer certains défauts transitoires, comme une notification qui disparaît rapidement ou une bannière d’erreur qui ne s’affiche que brièvement. Le mécanisme ne supprime donc pas l’évaluation par modèle ; il la concentre différemment dans le parcours.
Cette distinction aide à éviter une lecture trop large de la promesse. « Action rejouée » ne signifie pas « résultat validé sans modèle », puisque la vérification des assertions demeure active. De même, une interface qui change ne conduit pas nécessairement à une simple mise à jour transparente du test : le comportement prévu est une détection d’échec, l’invalidation du cache et un nouvel appel à l’agent. Pour une équipe, ce sont des étapes distinctes à observer dans les traces et à comparer avec ses tests existants.
Un scénario hypothétique pour repérer les étapes concernées
Imaginons un test de connexion dans une application : une étape demande de sélectionner le bouton de connexion, puis une autre consigne demande de saisir des informations et de vérifier l’écran obtenu. Cet exemple est hypothétique et ne décrit pas un essai réalisé avec Bug0. Il sert à poser les bonnes questions sur le découpage : l’action simple de sélectionner un bouton peut correspondre au type d’étape mis en cache ; une instruction qui regroupe plusieurs opérations ne bénéficie pas de cette même relecture ; enfin, vérifier que l’écran attendu est bien affiché reste une assertion, donc une évaluation à chaque passage selon la description publiée.
Le framework mentionne également des intégrations de courriels jetables, notamment mailsink et des adaptateurs communautaires comme Mailinator. La description indique qu’un test peut extraire des codes à usage unique ou des liens de connexion à partir d’une consigne en langage naturel. C’est une possibilité à examiner si les parcours de régression de l’équipe couvrent l’authentification par courriel ; cela ne démontre pas, à lui seul, la compatibilité avec un fournisseur ou une configuration particulière.
Ce qu’une équipe peut vérifier avant d’en faire un choix
Un premier cadrage consiste à séparer les étapes selon leur rôle, plutôt qu’à juger le dispositif sur la seule présence d’un agent. Pour chaque scénario envisagé, l’équipe peut identifier les actions unitaires susceptibles d’être rejouées, les consignes multi-actions qui resteront pilotées par l’agent et les assertions qui seront évaluées par la vision. Elle peut ensuite décider quelles traces lui permettront de comprendre une invalidation de cache ou un résultat contesté. Ce protocole est une proposition d’évaluation, pas un test de QA Agent exécuté ici.
- Décrire le parcours en étapes suffisamment distinctes pour repérer les actions unitaires et les directives complexes.
- Prévoir des cas où un repère de l’interface change, afin d’observer si l’action rejouée échoue puis déclenche l’invalidation annoncée.
- Examiner séparément les résultats des assertions visuelles et les opérations Playwright rejouées : les deux mécanismes ne sont pas équivalents.
- Comparer le comportement attendu avec celui de la suite actuelle, sans confondre une promesse de réduction de latence avec une mesure obtenue sur son propre projet.
Le contexte de fiabilité mérite aussi de rester visible. InfoQ rapporte que l’étude de Chevrot et ses coauteurs, publiée en avril 2025, observait un accord d’environ 60 % entre la meilleure architecture de test autonome évaluée et des testeurs humains professionnels. Ce chiffre concerne cette étude, ses modèles et son architecture ; il ne mesure pas Bug0 QA Agent. L’article attribue les pistes d’amélioration à la vérifiabilité des assertions et à l’ancrage des actions sur les éléments pertinents de l’application. Il invite donc à évaluer les preuves produites, pas seulement la capacité d’un agent à parcourir une interface.
Cette question rejoint, sans la répéter, celle des tests de régression pour les prompts IA : ici, le périmètre précis est l’exécution de scénarios de navigateur, avec un cache d’actions et des assertions visuelles. La nature de la régression recherchée et les éléments à contrôler ne sont pas les mêmes.
La licence fait partie de l’évaluation technique
InfoQ précise que QA Agent est distribué sous Functional Source License, version 1.1, avec une licence future ALv2. L’article qualifie la Functional Source License de source-available, et non d’open source, et signale des restrictions de non-concurrence pendant les deux premières années d’utilisation. Pour une équipe, le fait de pouvoir consulter du code ne suffit donc pas à conclure que les conditions d’usage conviennent à son projet. Il faut examiner la licence applicable et ses contraintes avant d’intégrer la bibliothèque, indépendamment de la qualité du mécanisme de test.
Au final, la proposition de Bug0 est surtout intéressante comme architecture hybride à examiner : les actions unitaires réussies peuvent être rejouées, tandis que les étapes complexes et les vérifications d’assertions conservent une dépendance à l’agent ou aux modèles de vision. La décision dépendra de la proportion de ces étapes dans les scénarios de l’équipe, de sa capacité à diagnostiquer les échecs et des conditions de licence. La publication d’une bibliothèque ne remplace pas cette évaluation dans le contexte réel du projet.
Comment citer
Citez l’URL canonique, l’auteur et la date de mise à jour. Distinguez nos analyses des affirmations de fournisseurs.
Julien Morel. (2026). Bug0 QA Agent : ce que le cache Playwright automatise — et ce qu’il laisse à l’agent. IA News Dev. https://ianewsdev.com/bug0-qa-agent-cache-playwright/ (consulté le 2026-11-03).
dans vos tests de navigateur, quelles étapes gagneraient à être rejouées directement et lesquelles doivent rester vérifiées par un modèle ?
Publié dans la discussion