Mistral présente Large 4 comme un modèle multimodal d’un billion de paramètres, dont 52 milliards seraient actifs. Pour une équipe de développement, la question utile n’est pas de convertir cette taille en promesse de productivité : c’est de distinguer les capacités annoncées, les évaluations publiées et les conditions permettant de tester le modèle sur ses propres tâches.
Dans son annonce du 6 octobre 2026, Mistral indique que l’API de preview est accessible dans Mistral Studio et prévoit de publier les poids vers la fin du mois. Ces deux modalités ne sont pas équivalentes : la première donne accès à un modèle servi par le fournisseur, tandis que la seconde était annoncée comme une publication à venir. L’annonce de Mistral Large 4 est la source des informations et des résultats examinés ici ; les performances citées sont donc à lire comme des résultats rapportés par l’éditeur, pas comme un essai indépendant de notre part.
Étape 1 : séparer taille du modèle et capacité utile
Le chiffre d’un billion décrit le nombre total de paramètres annoncé. Mistral précise que 52 milliards sont actifs et qualifie Large 4 de modèle multimodal. Ces caractéristiques donnent une idée de l’architecture et du périmètre revendiqué, mais ne permettent pas, à elles seules, de prédire le coût d’un appel, sa latence ou son intérêt dans un environnement de développement. L’annonce ne fournit pas ici une mesure comparable de ces éléments pour un workflow d’équipe.
La distinction compte aussi pour l’exploitation. Mistral indique que le modèle a été entraîné sur 3 800 GPU NVIDIA Grace Blackwell dans ses propres centres de données européens et que la preview est servie sur cette infrastructure. Cela décrit l’entraînement et l’hébergement de la preview ; ce n’est pas une preuve que les poids sont déjà disponibles pour un déploiement autonome. L’éditeur annonce séparément une future mise à disposition des poids.
Pour un développeur, il faut donc traiter le mode d’accès comme une caractéristique du produit, et non comme une conséquence automatique de l’étiquette « open-weight ». Une API hébergée permet d’examiner un service dans les conditions proposées par l’éditeur. Des poids publiés pourraient ouvrir d’autres options de déploiement, mais les détails d’architecture et de publication sont annoncés comme devant être précisés ultérieurement dans le billet.
Étape 2 : replacer les scores de code dans leur périmètre
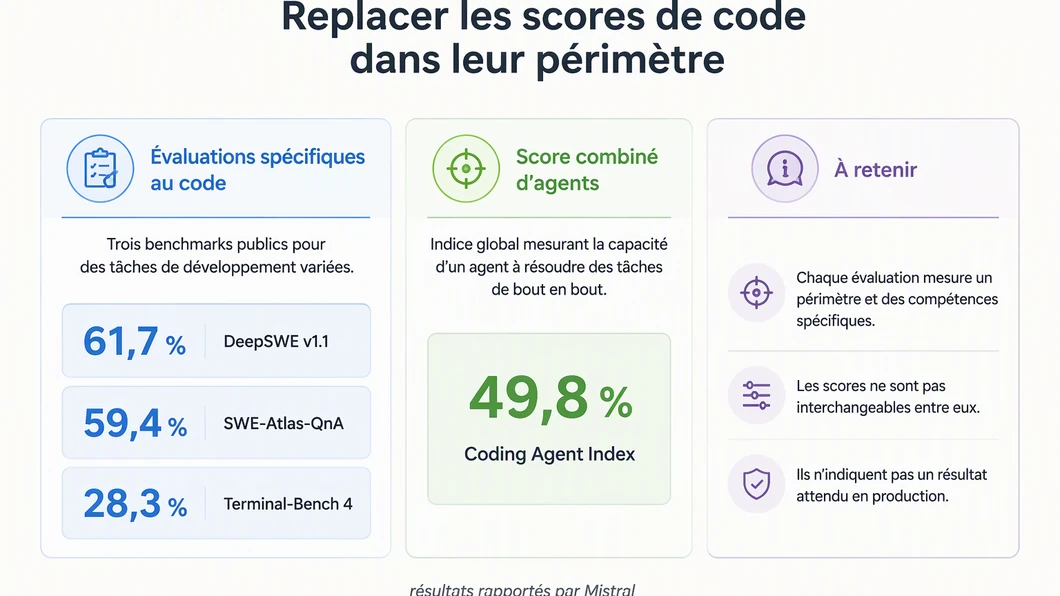
Mistral rapporte trois résultats sur des évaluations orientées développement : 61,7 % sur DeepSWE v1.1, 59,4 % sur SWE-Atlas-QnA et 28,3 % sur Terminal-Bench 4. L’entreprise donne également un score combiné de 49,8 % pour son Coding Agent Index. Ces valeurs ne décrivent pas une même tâche répétée trois fois : les noms renvoient à des évaluations différentes, et le score combiné constitue une mesure distincte.
| Élément annoncé | Ce qu’il renseigne | Précaution de lecture |
|---|---|---|
| DeepSWE v1.1 : 61,7 % | Un résultat sur une évaluation de développement nommée par Mistral | Ne pas le transposer directement au dépôt ou aux tâches de votre équipe |
| SWE-Atlas-QnA : 59,4 % | Un second point de mesure publié pour Large 4 | Le score n’établit pas à lui seul le niveau de réussite sur d’autres tâches |
| Terminal-Bench 4 : 28,3 % | Un résultat sur une évaluation distincte | À lire avec son protocole et ses critères, pas comme un pourcentage de tickets résolus en production |
La prudence ne signifie pas que ces évaluations sont inutiles. Elles donnent des repères sur des tâches définies par leurs benchmarks. Mais une équipe ne peut pas en déduire sans autre vérification que le modèle saura modifier son dépôt, respecter ses conventions, diagnostiquer une régression ou produire une pull request acceptable. Pour cadrer une comparaison sur ses propres tâches, la méthode de benchmark reproductible sur un dépôt traite précisément du protocole à définir avant de comparer des agents.
Étape 3 : distinguer classement et jugement humain
L’annonce décrit aussi une évaluation humaine à l’aveugle menée avec Surge AI : des annotateurs professionnels ont noté la qualité de réponses de code sur une échelle de 1 à 5, sans connaître l’identité des modèles. Mistral rapporte pour Large 4 Preview une note de 3,74 et la deuxième place parmi cinq modèles évalués. Ce résultat apporte un autre type d’indication que les scores de benchmark, mais il reste attaché au dispositif et au groupe de modèles présentés par l’éditeur.
Un classement n’indique pas automatiquement les critères décisifs pour votre équipe. La qualité d’une modification peut dépendre de la capacité à respecter une API existante, du comportement des tests, de la lisibilité du diff ou du temps de revue. Les résultats publiés peuvent aider à sélectionner une question d’essai ; ils ne remplacent pas la vérification de ces critères sur un périmètre représentatif.
Étape 4 : vérifier ce qui est accessible avant de planifier un essai
Dans son billet, Mistral dit que la preview API peut être essayée dans Mistral Studio et annonce la publication des poids vers la fin d’octobre. Il s’agit de l’état décrit dans l’annonce, datée du 6 octobre 2026 : elle ne suffit pas à établir la disponibilité actuelle de chaque option. Avant de bâtir une intégration, vérifiez les conditions d’accès et les informations de version au point d’entrée officiel.
Cette distinction influe sur ce qu’un essai peut réellement mesurer. Une évaluation via API porte sur le modèle et le service auxquels l’équipe a accès dans les conditions de la preview. Un essai avec des poids déployés par l’équipe ne pourrait être cadré qu’une fois ces poids effectivement accessibles et leurs modalités connues. Ne mélangez pas les résultats issus de conditions d’accès différentes dans une même comparaison sans les documenter.
Le billet annonce par ailleurs que des précisions sur l’architecture, des benchmarks supplémentaires et la méthode de post-entraînement doivent suivre. Cette réserve est importante : les scores disponibles dans l’annonce ne constituent pas à eux seuls un protocole complet permettant de reproduire les évaluations. Une comparaison solide devra consigner les tâches, la version utilisée, les entrées, les critères de réussite et les conditions d’exécution.
Checklist : avant de retenir Large 4 pour un workflow de code
- Notez si l’essai porte sur l’API de preview ou sur des poids effectivement disponibles ; ne confondez pas les deux.
- Choisissez des tâches représentatives de votre dépôt et formulez à l’avance ce qui compte comme une réussite.
- Conservez les entrées, les sorties et les critères de revue afin que l’évaluation puisse être répétée.
- Séparez les scores publiés par Mistral de vos observations locales, et attribuez clairement chaque résultat.
- Consignez les informations de version et les conditions d’accès au moment de l’essai.
- Si vous comparez plusieurs modèles, gardez les tâches et les critères constants ; la préparation d’une migration de modèle dans un workflow agentique complète cette démarche côté non-régression.
Large 4 apporte ainsi des éléments concrets à examiner : une architecture annoncée, des résultats sur des évaluations nommées et une preview API décrite par son éditeur. Pour les développeurs, la lecture la plus utile consiste à transformer ces éléments en questions de test, sans prendre les scores pour une garantie de résultat sur leur propre code. Les détails de méthode et les modalités d’accès doivent rester attachés à la version et au dispositif réellement évalués.
Comment citer
Citez l’URL canonique, l’auteur et la date de mise à jour. Distinguez nos analyses des affirmations de fournisseurs.
Julien Morel. (2026). Mistral Large 4 : comment lire ses résultats de code avant de l’évaluer. IA News Dev. https://ianewsdev.com/mistral-large-4-resultats-code/ (consulté le 2026-10-20).
quels critères utilisez-vous pour décider si un benchmark de code est pertinent pour votre dépôt ?
Publié dans la discussion