Un RAG peut aider une équipe à retrouver les éléments d’un crawl et à les relier aux questions de SEO technique. Mais une réponse pertinente dépend moins du choix d’un modèle que de la forme donnée aux preuves : une URL, un signal extrait, un modèle de page ou un lien entre plusieurs pages ne répondent pas aux mêmes questions.
Le périmètre proposé ici est précis : organiser des données de crawl pour répondre à des questions de diagnostic, sans demander au modèle de remplacer le crawler ni de décider seul d’une correction. Le crawl reste la source des observations ; le RAG aide à les retrouver, à les rapprocher et à présenter leur provenance.
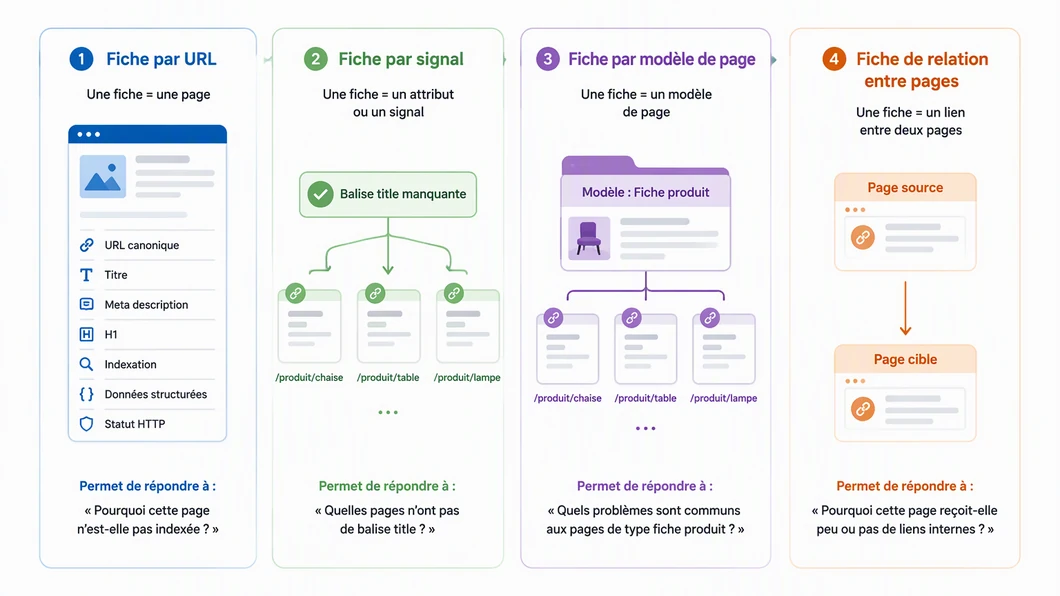
Quatre unités possibles pour les documents d’un RAG SEO
Avant d’indexer, il faut choisir ce qui constitue une unité de recherche. Une page complète est simple à conserver, mais peut mêler des signaux différents. À l’inverse, des fragments très petits sont précis, mais risquent de perdre le contexte de l’URL. Ces quatre modèles répondent à des besoins distincts.
| Modèle de document | Ce qu’il regroupe | Question à laquelle il convient | Limite principale |
|---|---|---|---|
| Fiche par URL | Les observations associées à une URL et à une exécution de crawl | Que relève le crawl pour cette page ? | Une fiche chargée peut mêler trop de signaux et de contenu |
| Fiche par signal | Un attribut ou une anomalie, lié à son URL d’origine | Quelles pages présentent ce signal ? | Le contexte de la page doit être récupéré séparément |
| Fiche par modèle de page | Des pages regroupées selon un modèle identifié et des observations comparables | Un problème semble-t-il partagé par un modèle de page ? | Un regroupement erroné peut masquer des différences entre URLs |
| Fiche de relation | Un lien entre une page source et une page cible, avec ses propriétés observées | Comment les pages sont-elles reliées dans le crawl ? | La relation seule n’explique pas le contenu ni l’état complet des pages |
1. La fiche par URL : le point de départ le plus facile à contrôler
Une fiche par URL conserve ensemble les observations utiles pour une page : URL demandée et URL finale, code de réponse observé, directives d’indexation relevées, canonical déclarée, titre extrait et liens détectés. Chaque valeur doit rester rattachée à son origine et à l’exécution du crawl. Si le rendu HTML et le HTML initial sont collectés séparément, il faut les distinguer plutôt que les fusionner.
Ce modèle convient à une question ciblée comme « quelles observations avons-nous pour cette page ? ». Il rend aussi les réponses plus faciles à vérifier : l’assistant peut citer la fiche et l’attribut concerné. En revanche, une fiche géante est difficile à retrouver finement. Il vaut mieux préserver des champs structurés et n’ajouter que les extraits de contenu utiles à la question.
2. La fiche par signal : retrouver des motifs sans perdre leur source
Pour rechercher toutes les pages associées à un signal, l’unité peut être le signal lui-même : une directive relevée, une canonical, un titre manquant ou un lien détecté. La fiche doit toutefois contenir l’URL concernée, la valeur observée, la provenance et le contexte nécessaire à l’interprétation. Une liste de signaux sans URL d’origine n’est pas une preuve exploitable.
La recherche exacte ou lexicale est souvent plus adaptée aux valeurs structurées qu’une proximité sémantique seule. Une question sur une directive précise n’a pas intérêt à recevoir des pages simplement « proches » dans le sens général. Le filtrage par type de signal, statut de crawl ou modèle de page peut ensuite réduire le périmètre avant la génération de la réponse.
3. La fiche par modèle : comparer des pages qui ont réellement un même rôle
Un modèle de page peut réunir des observations communes à des pages comparables, par exemple des pages de catégorie ou des fiches produit, si cette classification est disponible et fiable. L’intérêt est de repérer une piste de diagnostic à l’échelle d’un gabarit. Mais le regroupement ne doit pas transformer une hypothèse en constat : la réponse doit permettre de revenir aux URLs individuelles et à leurs valeurs observées.
Une fiche de modèle ne remplace donc pas les fiches par URL. Elle les relie à une catégorie de comparaison. Si l’origine du classement est incertaine, ou si plusieurs gabarits sont mélangés, mieux vaut ne pas présenter les pages comme un ensemble homogène.
4. La fiche de relation : représenter le maillage comme des liens vérifiables
Pour les questions de maillage interne, chaque relation peut être représentée par une page source, une page cible et les propriétés relevées lors du crawl, comme l’ancre extraite. L’assistant peut alors retrouver des chemins et des relations sans devoir inférer les liens à partir du seul texte des pages.
Cette représentation est complémentaire aux fiches de pages, pas un substitut. Elle décrit les liens observés dans un crawl donné ; elle ne prouve ni la découverte d’une page par un moteur ni son état d’indexation. Pour cadrer le rôle général du mécanisme, voir aussi le guide sur le RAG appliqué à la documentation technique.
Choisir la recherche selon la question SEO
Les quatre modèles peuvent coexister. Une recherche par URL ou par attribut exact sert les requêtes précises ; une recherche lexicale aide à retrouver des termes et libellés ; une recherche sémantique peut aider à comprendre une question formulée différemment des champs indexés. Une approche hybride peut combiner ces voies, à condition de conserver des filtres et des références vers les observations d’origine.
Le choix doit suivre la question, pas l’inverse. « Quelles pages ont cette valeur ? » appelle des champs structurés. « Quelles pages ressemblent à cet exemple ? » peut tirer parti du texte ou d’une représentation sémantique, mais doit ensuite ramener des preuves concrètes. Pour un changement SEO proposé dans du code, le contrôle du HTML rendu et des pages concernées reste une tâche distincte ; la vérification SEO WordPress assistée par IA traite ce besoin de validation.
Une liste de contrôle avant de brancher le RAG
- Conserver l’URL et l’exécution de crawl auxquelles chaque observation se rapporte.
- Séparer les valeurs structurées des extraits de texte, sans perdre le lien entre elles.
- Choisir l’unité de document en fonction des questions réellement posées.
- Permettre de remonter des réponses aux URLs et aux champs observés.
- Présenter les données de crawl comme des observations datées, pas comme une preuve de l’état actuel d’un moteur.
- Faire apparaître les données manquantes ou ambiguës au lieu de les compléter par déduction.
La frontière à garder nette
Un RAG pour le SEO technique est une couche de recherche et de synthèse sur des données sélectionnées. Sa qualité se joue dans la granularité des documents, les filtres et la traçabilité des réponses. Il peut aider à formuler une piste à partir d’un crawl ; il ne rend pas cette piste vraie et ne valide pas une modification en production. Pour une équipe de développement, cette séparation est le contrat essentiel : retrouver les preuves d’abord, décider et vérifier ensuite.
Comment citer
Citez l’URL canonique, l’auteur et la date de mise à jour. Distinguez nos analyses des affirmations de fournisseurs.
Julien Morel. (2026). RAG pour le SEO technique : comparer quatre façons d’indexer les données d’un crawl. IA News Dev. https://ianewsdev.com/rag-seo-technique-donnees-crawl/ (consulté le 2026-10-21).

quelle donnée de crawl vous manque le plus souvent lorsqu’il faut diagnostiquer un problème SEO technique ?
Publié dans la discussion