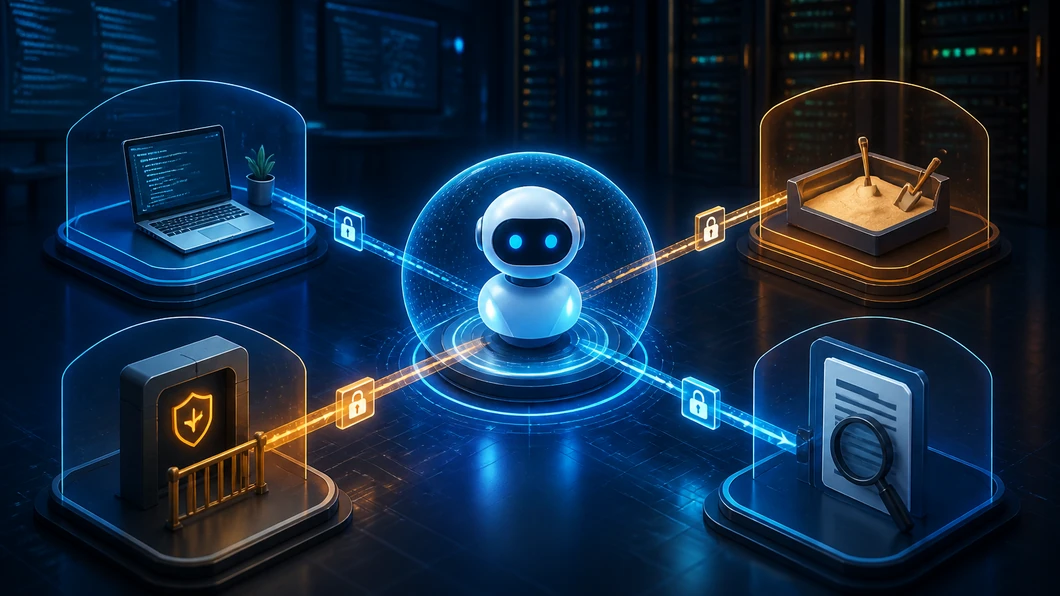
Connecter un agent de développement à un serveur MCP ne revient pas seulement à ajouter une entrée dans un fichier de configuration. Le choix de l’architecture détermine ce que l’agent peut voir, les actions qu’il peut demander, l’endroit où une règle de sécurité s’applique et la facilité avec laquelle l’équipe peut arrêter ou examiner le flux.
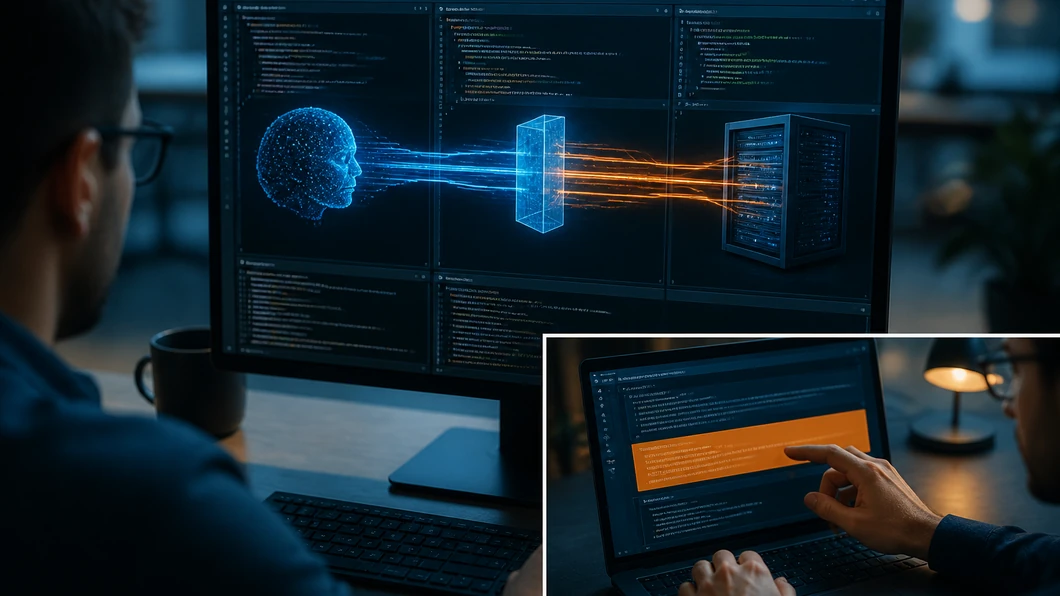
Le sujet est différent de l’authentification seule. Le protocole officiel impose notamment de valider l’audience des jetons, d’éviter le transfert direct de jetons vers un service tiers et de protéger le flux d’autorisation avec PKCE lorsque le client le permet. Ces contrôles sont nécessaires, mais ils ne répondent pas à une question plus opérationnelle : où placer la limite entre l’agent, le serveur MCP et le système réellement modifié ? La documentation de sécurité du protocole MCP détaille ces exigences d’autorisation.
Le problème : un même outil MCP peut créer quatre niveaux de risque
Un serveur MCP qui lit une documentation synthétique n’expose pas la même surface qu’un serveur capable de modifier des tickets, des fichiers ou une infrastructure. Pourtant, dans les deux cas, l’agent peut présenter l’appel comme une étape naturelle de sa tâche. La différence se trouve dans les permissions effectives, le réseau disponible, les données retournées et la possibilité de faire relire l’action avant son exécution.
Une équipe qui choisit uniquement selon la simplicité d’installation risque donc de confondre quatre décisions : connecter un outil, autoriser une opération, transmettre des données et laisser une action produire un effet durable. Une architecture sûre sépare ces décisions au lieu de les déléguer au modèle.
Quatre architectures à comparer
| Architecture | Ce que l’agent obtient | Contrôle principal | Quand la choisir | Limite |
|---|---|---|---|---|
| Serveur local direct | Un accès local à un jeu d’outils défini par la configuration du poste | Permissions du compte, liste d’outils et isolation du poste | Exploration, lecture de fixtures et prototypage individuel | La frontière dépend fortement du poste et des réglages locaux |
| Serveur dans un bac à sable | Un environnement séparé avec données synthétiques et outils bornés | Isolation du système de fichiers, réseau limité et nettoyage | Essais défensifs, validation de scripts et reproduction d’un scénario | Il faut maintenir les fixtures et vérifier que le bac à sable ressemble assez au cas réel |
| Passerelle de contrôle | Des appels filtrés avant leur transmission au serveur MCP | Politique centrale, identité, quotas, journal et approbation | Équipes, outils partagés et actions sensibles | Une passerelle ne corrige pas une réponse ou une définition d’outil trompeuse |
| Outils en lecture seule | Des ressources et opérations qui ne modifient pas directement le système | Contrat d’outil, filtrage des données et revue humaine des changements | Commencer par documenter, diagnostiquer et préparer une pull request | La lecture peut tout de même exposer des données sensibles ou influencer une décision |
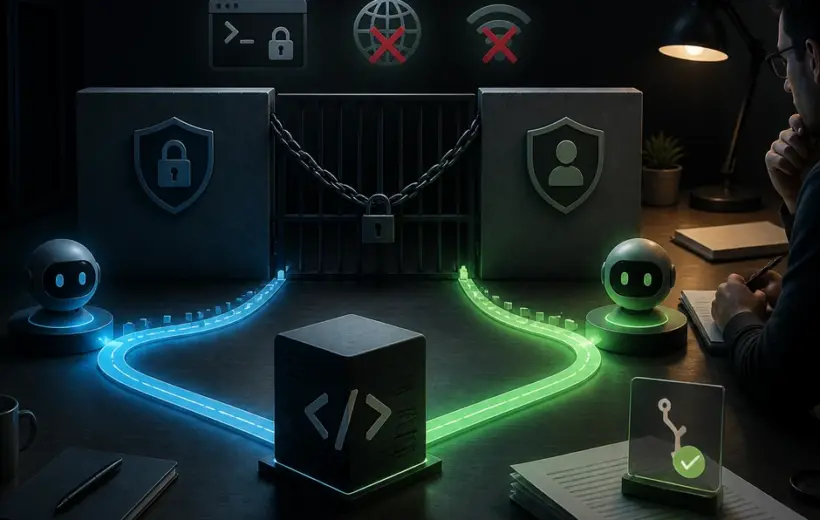
Cette matrice ne classe pas les architectures de la meilleure à la moins bonne. Elle aide à placer le contrôle au plus près du risque. Un serveur local peut être adapté à une fixture sans secret. Une passerelle devient plus utile lorsque plusieurs développeurs partagent les mêmes outils. Un mode en lecture seule réduit l’impact d’une mauvaise décision, sans rendre les données publiques ou inoffensives.
Solution 1 : commencer par un outil qui ne peut pas écrire
Pour un premier usage, la lecture seule est souvent le périmètre le plus facile à vérifier. L’agent peut rechercher dans une documentation de projet, analyser une sortie de test ou préparer une proposition de modification. Il ne pousse pas de commit, ne modifie pas un ticket et ne déclenche pas de déploiement.
Cette étape ne doit pas être présentée comme une sécurité complète. Un outil de lecture peut retourner un secret présent dans une fixture, une instruction malveillante dans une documentation ou un volume de données disproportionné. Il faut donc filtrer les ressources, réduire les champs retournés et définir ce que le serveur refuse de transmettre.
Le bon critère n’est pas « l’outil est-il en lecture ? », mais « quelles données peut-il lire et quelle décision cette sortie peut-elle influencer ? ». Une réponse qui alimente automatiquement une commande ou une pull request mérite un contrôle supplémentaire, même si l’appel initial ne modifie rien.
Solution 2 : isoler les essais dans un bac à sable
Un bac à sable convient lorsqu’il faut observer un comportement plutôt que simplement consulter une information. Le dépôt d’essai doit contenir des données synthétiques, des comptes sans privilèges et un réseau explicitement limité. La session doit pouvoir être recréée à partir d’un état initial connu, puis supprimée sans laisser de jeton ou de fichier temporaire.
Pour préparer un test défensif, séparez trois capacités : lire les fichiers, exécuter une commande et publier un résultat. L’agent peut recevoir la première, parfois la deuxième, mais la troisième doit rester derrière une validation humaine. Cette séparation rend visible le moment où une suggestion devient une action durable.
Vous pouvez compléter ce dispositif avec un bac à sable pour agents IA de code, notamment pour formaliser le périmètre, les données de test et le nettoyage entre deux sessions.
Solution 3 : placer une passerelle devant les actions partagées
Une passerelle est pertinente lorsque le serveur MCP est utilisé par plusieurs postes, plusieurs agents ou plusieurs équipes. Elle peut centraliser l’identité, appliquer une liste d’outils autorisés, limiter la fréquence, journaliser les appels et demander une approbation avant une opération sensible.
La passerelle ne doit toutefois pas être réduite à un proxy réseau. La version actuelle de la spécification MCP ajoute des métadonnées de méthode et d’outil dans les requêtes HTTP, ce qui permet à une infrastructure de routage ou de filtrage d’identifier plus directement certains appels. L’analyse récente d’InfoQ sur MCP stateless décrit l’intérêt de ces métadonnées pour le routage, la limitation et la mesure du trafic.
Le contrôle doit intervenir avant l’exécution, avec le contexte utile : identité, outil demandé, paramètres, environnement cible et niveau de réversibilité. Une règle qui ne voit que le nom du serveur ne peut pas distinguer une lecture inoffensive d’une écriture dangereuse. Une règle qui intervient après l’envoi n’est plus un contrôle préventif.
Solution 4 : traiter les définitions d’outils comme du code à relire
Un outil MCP n’est pas seulement un endpoint. Sa description, son schéma de paramètres, ses annotations et les données qu’il renvoie influencent la décision de l’agent. Une équipe doit donc relire ces éléments avant d’accorder sa confiance, puis surveiller les changements de définition.
Le risque peut apparaître sans erreur d’authentification : un outil reste autorisé, mais sa description évolue, son paramètre devient plus large ou sa sortie contient une instruction qui détourne la tâche. La passerelle peut limiter l’appel sans détecter cette dérive sémantique. Il faut conserver une version approuvée du manifeste et examiner les différences avant activation.
Cette approche rejoint les principes de sécurité publiés par GitHub pour ses agents : réduire l’autonomie, améliorer l’interprétabilité et conserver une intervention humaine lorsque l’outil peut produire un effet important. Les principes de sécurité agentique de GitHub présentent cette logique comme un équilibre entre utilité et contrôle.
Anecdote hypothétique : le serveur « lecture seule » qui ne l’était plus vraiment
Imaginez une équipe qui connecte un agent à un serveur MCP chargé de rechercher des issues. Le serveur n’expose officiellement qu’une lecture. Après une évolution, sa sortie inclut un lien vers une action de création de branche et l’agent reçoit aussi les droits nécessaires dans son environnement local. Aucun mot de passe n’a fuité et l’authentification fonctionne. Pourtant, le périmètre réel a changé : la sortie peut désormais guider une modification qui n’était pas prévue dans le premier scénario.
La correction ne consiste pas à demander à l’agent d’être plus prudent. Il faut comparer le manifeste approuvé, vérifier les droits effectifs, réduire les données retournées et placer l’écriture derrière une étape distincte. L’incident est hypothétique, mais le contrôle proposé est reproductible sur un dépôt de test sans secret réel.
La décision en pratique
- Commencez par un outil en lecture seule et une donnée synthétique.
- Ajoutez l’exécution dans un bac à sable avant toute connexion à un dépôt réel.
- Définissez les actions qui exigent une approbation humaine.
- Placez une passerelle lorsque les outils deviennent partagés ou persistants.
- Versionnez les définitions d’outils et refusez les changements non relus.
- Journalisez l’appel, le résultat utile, la décision humaine et l’état final sans enregistrer de secret.
Pour relier cette architecture au workflow de livraison, vous pouvez aussi consulter la méthode d’intégration d’agents IA dans la CI/CD. L’objectif n’est pas de rendre MCP autonome par défaut, mais de rendre chaque extension de capacité visible, réversible et proportionnée à la tâche.
Le choix le plus prudent est rarement le plus spectaculaire : commencer par lire, isoler ce qui doit être exécuté, puis n’autoriser l’écriture qu’avec une identité, une politique et une preuve adaptées. MCP facilite la connexion entre un agent et des outils ; l’architecture doit encore décider jusqu’où cette connexion peut aller.
Comment citer
Citez l’URL canonique, l’auteur et la date de mise à jour. Distinguez nos analyses des affirmations de fournisseurs.
Julien Morel. (2026). Sécurité MCP : quelle architecture choisir avant de connecter un agent aux outils ?. IA News Dev. https://ianewsdev.com/securite-mcp-architecture-agent-outils/ (consulté le 2026-09-24).
quelle architecture MCP utilisez-vous aujourd’hui pour isoler les outils capables d’écrire ou d’agir ?
Publié dans la discussion