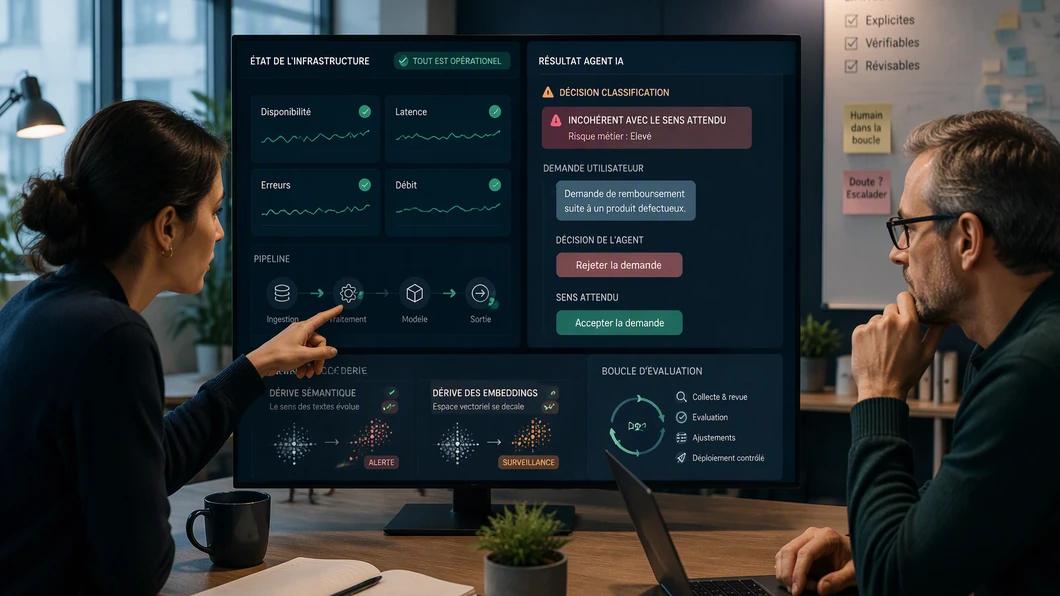
Un service peut afficher des contrôles d’infrastructure au vert tout en prenant de mauvaises décisions. Pour les équipes qui mettent des agents IA en production, le problème n’est donc pas seulement de repérer une panne : il faut aussi détecter quand le système continue de fonctionner, mais ne comprend plus les données ou les règles métier de la même façon.
Le compte rendu publié par InfoQ le 16 octobre 2026 rapporte plusieurs exemples discutés lors d’un webinaire sur les systèmes agentiques en production. Ils permettent de distinguer deux dérives souvent invisibles dans les contrôles classiques : le sens qui se déforme dans un pipeline et le comportement qui change après une évolution du modèle d’embeddings. La réponse utile consiste à relier ces signaux à des évaluations continues et à des limites d’action explicites.
Quand le service répond, mais que le résultat métier dévie
La dérive sémantique ne ressemble pas nécessairement à une erreur technique. Dans le cas décrit par InfoQ, un agent de traduction texte-SQL aplatit des notions qui dépendent du domaine métier. Il décrit des agents de traduction texte-SQL qui aplatissent des notions métier propres à chaque domaine : « membre » peut être interprété de la même façon en ventes et en support client, créant des erreurs discrètes dans les analyses en aval.
Une requête peut alors produire une réponse plausible et traverser les étapes habituelles, tout en reposant sur une interprétation inadéquate. Ce type de défaut appelle une vérification du sens attendu, pas seulement du bon déroulement technique. Pour une équipe, la question devient : quels termes ou catégories changent de signification selon le contexte, et comment vérifier que cette distinction est conservée jusqu’au résultat consommé ?
Un autre cas rapporté concerne les embeddings d’un système de conformité financière. Dans un autre cas rapporté par InfoQ, une mise à jour non annoncée du modèle d’embeddings a déplacé la distribution des distances vectorielles ; le système a alors connu des pics de faux positifs et de faux négatifs alors que les contrôles de santé de l’infrastructure restaient au vert.
Ces deux situations ne sont pas identiques. La première concerne l’interprétation de notions métier ; la seconde, le changement de comportement lié à la représentation vectorielle utilisée par le système. Mais elles ont un point commun opérationnel : un tableau de bord qui suit la disponibilité ou l’état des composants ne suffit pas, à lui seul, à établir que les décisions restent conformes à l’intention. Pour le suivi des exécutions, voir aussi notre guide sur les traces et métriques d’observabilité des agents IA.
| Signal à examiner | Ce qu’il peut révéler | Question de contrôle |
|---|---|---|
| Résultat métier inattendu sans erreur technique | Une notion ou une règle a pu être interprétée autrement | Le résultat respecte-t-il la définition métier attendue pour ce contexte ? |
| Variation des décisions après une évolution des embeddings | La distribution des distances ou les seuils utilisés peuvent ne plus produire le même comportement | Les cas de référence donnent-ils toujours les décisions attendues ? |
| Contrôles d’infrastructure normaux malgré des décisions contestées | Les contrôles de santé ne couvrent pas nécessairement la qualité sémantique | Quelles traces relient l’entrée, le contexte, la décision et son effet ? |
Ce tableau est une grille de diagnostic, pas un résultat de test. Il traduit les cas rapportés en questions à intégrer à l’observation du système, sans supposer qu’un indicateur unique suffira à détecter toutes les dérives.
Déplacer la revue vers les bons contrôles
Quand un agent produit beaucoup de code, relire chaque ligne manuellement devient difficile à faire évoluer avec le rythme de production. Le compte rendu rapporte la proposition de déplacer les contrôles tactiques vers la CI/CD et de réserver la revue humaine aux décisions qui exigent du jugement sur l’architecture, l’intention métier et les exigences non fonctionnelles. Le panel distingue implicitement deux niveaux de revue : automatiser les contrôles tactiques de style et de syntaxe dans la CI/CD, puis réserver la revue humaine à l’architecture, à l’intention métier et aux exigences non fonctionnelles.
Cette séparation n’équivaut pas à confier la validation à l’agent. Elle vise à rendre explicite ce qui peut être vérifié de façon répétable et ce qui doit rester une décision d’ingénierie. Le compte rendu mentionne aussi le mutation testing : introduire délibérément des changements dans le code pour vérifier si les tests détectent une altération de la logique, au lieu de se fier uniquement à un indicateur de couverture. C’est un point important pour les équipes qui veulent savoir si leurs tests contrôlent réellement le comportement attendu.
Pour les systèmes agentiques, les évaluations ne devraient pas être traitées comme une formalité achevée avant le lancement. Chu défend des évaluations permanentes plutôt qu’une checklist figée avant lancement : le suivi continu des traces au niveau des spans doit aider à capter les interactions réelles et à réinjecter les cas limites de production dans les benchmarks hors ligne.
Concrètement, une boucle d’évaluation peut relier une interaction observée à un cas de référence, puis vérifier le comportement lors d’une évolution du modèle, du contexte ou du pipeline. C’est une démarche à concevoir selon le système : le compte rendu décrit des pratiques évoquées par les intervenants, mais ne fournit pas de résultats d’un essai comparatif permettant d’établir leur efficacité dans tous les environnements.
Un ordre de diagnostic avant d’élargir l’autonomie
Pour éviter de confondre disponibilité et fiabilité du résultat, une équipe peut organiser l’examen dans cet ordre. Il s’agit d’une méthode proposée à partir des problèmes rapportés, et non d’un protocole présenté comme testé.
-
Décrire la décision attendue. Pour chaque tâche importante, préciser les distinctions métier qui ne doivent pas être aplaties et les erreurs qui changeraient le résultat en aval.
-
Choisir des cas de référence. Inclure des entrées représentatives des contextes différents et des cas limites déjà observés, sans les réduire à un score global.
-
Relier les traces au résultat. Conserver assez d’éléments pour examiner l’entrée, le contexte utile, la décision et l’effet produit, en tenant compte des exigences de confidentialité.
-
Répéter l’évaluation après un changement. Une évolution du modèle d’embeddings ou du pipeline doit conduire à vérifier les cas de référence avant de conclure que le comportement reste stable.
-
Définir une limite d’action. Séparer ce que l’agent peut lire, ce qu’il peut modifier de manière réversible et ce qui demande une approbation humaine.
Avant d’élargir l’usage d’un agent, cette checklist aide à repérer les points qui restent flous :
- Les notions métier sensibles sont-elles définies pour chaque contexte où elles sont utilisées ?
- Les évaluations couvrent-elles les décisions attendues, et pas seulement la disponibilité des composants ?
- Les changements de modèle ou de pipeline déclenchent-ils une nouvelle vérification des cas de référence ?
- Les contrôles automatiques et les décisions réservées à une personne sont-ils distingués ?
- Les droits de l’agent et les données auxquelles il accède sont-ils limités à son besoin ?
Encadrer l’agent comme un composant qui agit
La qualité des réponses n’est qu’une partie du risque : un agent relié à des outils peut aussi agir sur des systèmes ou manipuler des données sensibles. Le compte rendu rapporte des recommandations de sécurité qui dépassent le prompt : modélisation continue des menaces, périmètre fonctionnel strict et exercices de red team. Il mentionne également des identités non humaines distinctes, des niveaux d’accès gradués, le versionnement des dépendances MCP et l’isolement des secrets API hors de l’environnement d’exécution.
Pour limiter le rayon d’action d’un agent, le panel recommande une identité non humaine distincte, des accès gradués entre lecture seule et écritures réversibles, le versionnement des dépendances MCP et l’isolement des secrets API hors de l’environnement d’exécution.
Ces contrôles ne remplacent pas la décision de déploiement. Le compte rendu indique que les équipes d’ingénierie, de sécurité et de confidentialité valident les garde-fous, tandis que l’approbation du déploiement reste une décision stratégique de l’entreprise. Cette répartition oblige à rendre visibles les risques résiduels et les limites d’action avant d’autoriser un agent à intervenir en production.
Le point central est simple : un système peut rester disponible tout en dérivant dans son interprétation ou ses décisions. Pour le détecter, il faut observer les résultats métier, maintenir des évaluations au fil des changements et borner les actions possibles. Les voyants d’infrastructure restent utiles, mais ils ne constituent pas à eux seuls une preuve que le comportement d’un agent demeure correct.
Comment citer
Citez l’URL canonique, l’auteur et la date de mise à jour. Distinguez nos analyses des affirmations de fournisseurs.
Julien Morel. (2026). Agents IA en production : repérer les dérives que les voyants verts ne montrent pas. IA News Dev. https://ianewsdev.com/agents-ia-production-derives-silencieuses/ (consulté le 2026-10-23).
quel signal vous a aidé à repérer une dérive d’un système IA avant qu’elle ne devienne un incident ?
Publié dans la discussion