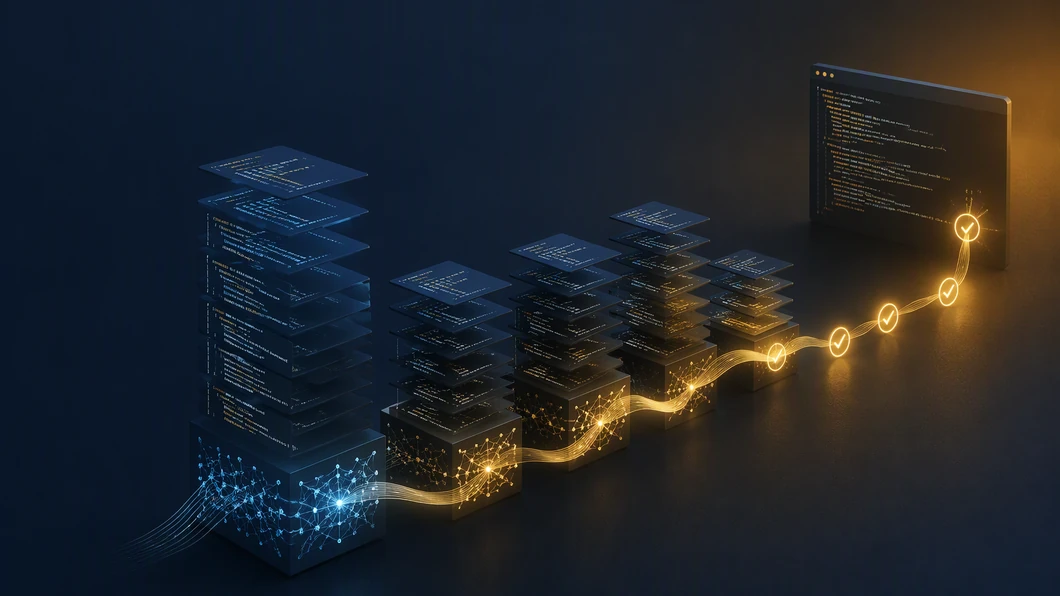
Une étude de cas publiée par CodeScene et rapportée par InfoQ décrit un chantier spectaculaire : des agents de code auraient refactoré 300 000 lignes de C en trois semaines, pour environ 4 000 dollars de tokens. Le résultat aurait été vérifié par un harness de replay image par image. Les agents auraient aussi construit progressivement un playbook de recettes propres au codebase.
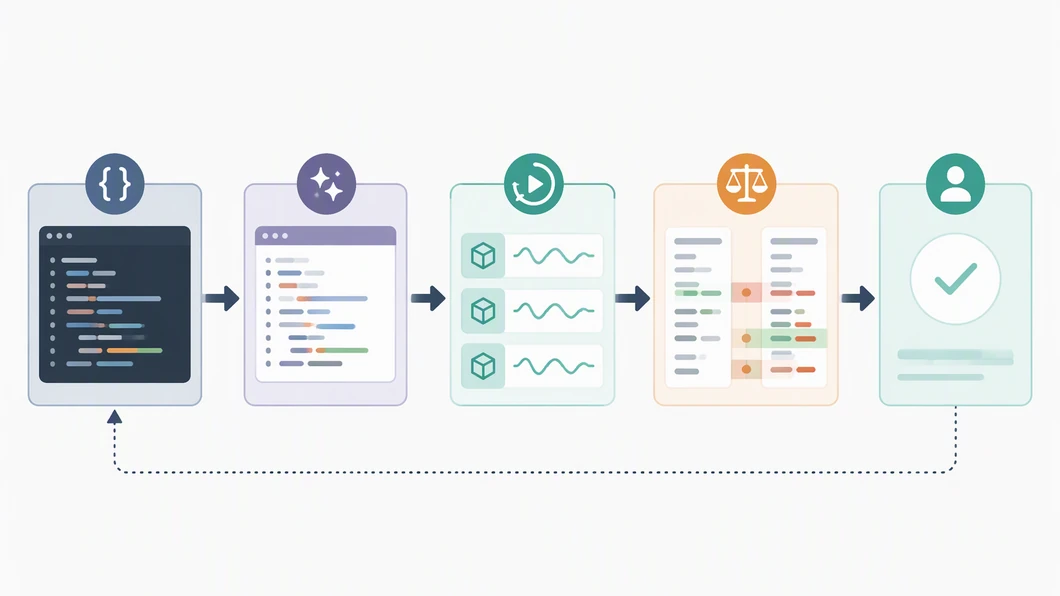
Ces éléments sont intéressants, mais ils ne suffisent pas à conclure que les agents savent refactorer seuls un système legacy à grande échelle. La vraie question est plus précise : quelle partie de la performance vient de l’agent, quelle partie vient du protocole de vérification, et que mesure exactement le volume de lignes modifiées ?
Le chiffre attire l’attention, mais ne constitue pas encore une preuve de qualité
« 300 000 lignes » décrit une taille de périmètre. Ce chiffre ne dit pas combien de transformations ont été sémantiquement difficiles, combien de fichiers ont été touchés, combien de changements ont été rejetés ou combien de corrections humaines ont été nécessaires.
Le coût annoncé, environ 4 000 dollars de tokens, est lui aussi une information partielle. Il renseigne sur la consommation de modèle dans le cadre décrit, pas sur le coût complet du chantier. Le temps consacré à la préparation du dépôt, à la conception du harness, à l’analyse des échecs, à la revue et à la maintenance du playbook n’est pas détaillé dans l’extrait disponible.
Un lecteur doit donc éviter deux raccourcis : prendre le volume comme une mesure de productivité et prendre le coût de tokens comme le prix total de la refactorisation.
Le harness de replay déplace le centre de gravité vers la vérification
La vérification par replay image par image est le point le plus important de l’étude de cas. Elle suggère que le chantier ne repose pas uniquement sur une relecture humaine du diff. Le système cherche à rejouer le comportement observable et à comparer les étapes du résultat.
C’est une différence majeure avec une démonstration où l’agent produit un patch puis affirme que les tests passent. Un replay peut rendre les écarts plus visibles, isoler une étape fautive et fournir une trace exploitable. Mais il ne transforme pas automatiquement toute divergence en bug, ni toute correspondance en preuve de préservation du comportement.
La portée de la conclusion dépend donc du périmètre couvert par le harness. Vérifie-t-il des scénarios représentatifs, des entrées rares, des erreurs, des effets de bord et des comportements dépendants de l’environnement ? L’extrait de la source ne permet pas de répondre à ces questions. Il permet seulement de retenir que la vérification automatisée occupe une place centrale dans le cas présenté.
Les recettes propres au codebase sont un actif, pas une garantie
Selon le dossier, les agents ont constitué un playbook de recettes spécifiques au codebase au fil du travail. Cette évolution est crédible comme principe de fonctionnement : un dépôt ancien contient souvent des conventions, des dépendances implicites et des formes de code que des règles générales ne décrivent pas bien.
Un playbook peut alors réduire les erreurs répétitives. Il peut préciser où chercher un contrat, quelles transformations sont acceptables et quels contrôles relancer après une modification. Il devient une mémoire opérationnelle du chantier.
Mais cette mémoire doit elle-même être contrôlée. Une recette issue d’un changement mal compris peut accélérer la répétition d’une erreur. Chaque règle devrait être associée à un exemple, à une condition d’application et à une preuve de validation. Sans cela, le playbook risque de devenir une collection d’heuristiques difficiles à contester.
Quatre questions à poser avant de reprendre la promesse
- Quel était le périmètre exact ? Il faut distinguer le nombre total de lignes du nombre de lignes réellement modifiées et la nature des transformations effectuées.
- Quel comportement était couvert ? Une vérification utile doit préciser les scénarios rejoués, les données utilisées et les limites connues.
- Quel rôle jouait l’humain ? La présence d’un agent ne renseigne pas, à elle seule, sur le niveau d’autonomie. Il faut savoir qui définissait les étapes, tranchait les ambiguïtés et acceptait les exceptions.
- Qu’est-ce qui a échoué ? Les échecs, les reprises et les changements abandonnés sont aussi importants que le résultat final pour juger la méthode.
Cette grille complète les méthodes de benchmark reproductible d’agents de code : elle ne cherche pas à produire un classement, mais à séparer le volume traité, la qualité observée et la force de la preuve.
Une lecture plus utile que le record de volume
| Élément observé | Ce qu’il indique | Ce qu’il ne prouve pas |
|---|---|---|
| 300 000 lignes | L’ampleur annoncée du périmètre | La difficulté uniforme des changements |
| Trois semaines | La durée déclarée du chantier | Le temps humain total consacré au contrôle |
| Environ 4 000 dollars de tokens | Une consommation de modèle rapportée | Le coût complet de livraison et de maintenance |
| Replay image par image | Un mécanisme de comparaison et de traçabilité | La couverture de tous les comportements importants |
| Playbook spécifique | Une capitalisation des recettes du dépôt | La validité automatique de chaque recette |
Cette séparation est essentielle pour éviter de confondre capacité de production et capacité de preuve. Un agent peut générer rapidement un grand nombre de modifications tout en laissant à l’équipe la tâche la plus délicate : démontrer que le système continue de faire ce qu’il doit faire.
Checklist pour analyser une étude de cas agentique
- Le périmètre technique et la nature des transformations sont-ils explicités ?
- La version des outils, l’environnement et les données de replay sont-ils indiqués ?
- Les résultats bruts incluent-ils les échecs et les reprises ?
- Le harness vérifie-t-il seulement le chemin nominal ou aussi les cas limites ?
- Le coût annoncé sépare-t-il tokens, infrastructure et temps humain ?
- Les recettes du playbook sont-elles relisibles, versionnées et réversibles ?
- Une autre équipe pourrait-elle reconstruire le protocole sans ajouter d’hypothèses invisibles ?
Ce que le cas permet raisonnablement de retenir
Le dossier ne permet pas de conclure que les agents ont démontré une refactorisation autonome et généralisable de 300 000 lignes de C. Il montre plutôt une hypothèse industrielle intéressante : un agent devient plus exploitable lorsqu’il travaille avec un harness de vérification et qu’il capitalise les particularités du dépôt.
La leçon pour une équipe de développement n’est donc pas de viser immédiatement un volume record. Elle consiste à construire d’abord une boucle où chaque transformation est observable, rejouable et stoppable. Le volume vient ensuite, si les preuves restent proportionnées à la surface de risque.
Pour approfondir la question de la cartographie et de l’enquête avant toute refonte, consultez aussi les usages des agents de code pour éclairer une architecture logicielle.
Comment citer
Citez l’URL canonique, l’auteur et la date de mise à jour. Distinguez nos analyses des affirmations de fournisseurs.
Julien Morel. (2026). 300 000 lignes refactorées par des agents : ce que la preuve permet vraiment de conclure. IA News Dev. https://ianewsdev.com/refactorisation-agents-300000-lignes-preuve/ (consulté le 2026-10-02).
dans votre équipe, quel élément vous ferait confiance à une refactorisation réalisée par un agent : le replay, les tests, la revue humaine ou une autre preuve ?
Publié dans la discussion