Dans un projet WordPress, une proposition générée rapidement n’est pas encore un résultat rentable. Il faut parfois relire le diff, vérifier les hooks, exécuter les tests, contrôler les droits, comparer le rendu et corriger ce que l’assistant a déplacé. Le temps économisé à l’écriture peut donc réapparaître dans la validation.
Pour décider si un usage mérite d’être étendu, il vaut mieux mesurer le coût d’une tâche terminée que le volume de code produit. Cette approche ne donne pas un ROI universel : elle aide à comparer des usages WordPress avec les mêmes critères et à arrêter ceux dont la revue absorbe le gain.
Cette logique rejoint les recommandations publiées par GitHub sur l’efficacité des agents de code : le bon niveau de mesure se situe à l’échelle de la tâche complète, et non d’un seul appel ou d’un seul volume de tokens.
Le bon périmètre : une tâche WordPress terminée
Le périmètre proposé ici est volontairement plus étroit que le calcul global du budget IA. Il porte sur une tâche identifiable, avec un début, une sortie vérifiable et une décision de merge. Par exemple : corriger un test de plugin, préparer un petit changement de template ou documenter un hook existant. Une refonte complète de thème ne constitue pas une unité comparable.
Le coût utile comprend quatre éléments : le temps de préparation, le temps d’interaction avec l’outil, le temps de revue et le coût des corrections ou reprises. Si la tâche échoue ou si le changement est abandonné, cette sortie doit rester visible dans le relevé au lieu d’être retirée du calcul.
Quatre usages à comparer sans les mélanger
| Usage WordPress | Valeur attendue | Point de contrôle principal | Signal de rentabilité |
|---|---|---|---|
| Documentation d’un plugin ou d’un thème | Réduire le temps de compréhension d’un code existant | Exactitude des hooks, dépendances et hypothèses | La relecture reste courte et les omissions sont détectables |
| Tests ciblés sur une fonction ou un callback | Accélérer la couverture de cas connus | Le test vérifie le comportement, pas seulement l’implémentation | Les cas ajoutés sont conservés après revue |
| Correction locale de plugin | Réduire le temps d’un changement limité | Capacités, nonces, validation, échappement et compatibilité | Le diff reste borné et reproductible |
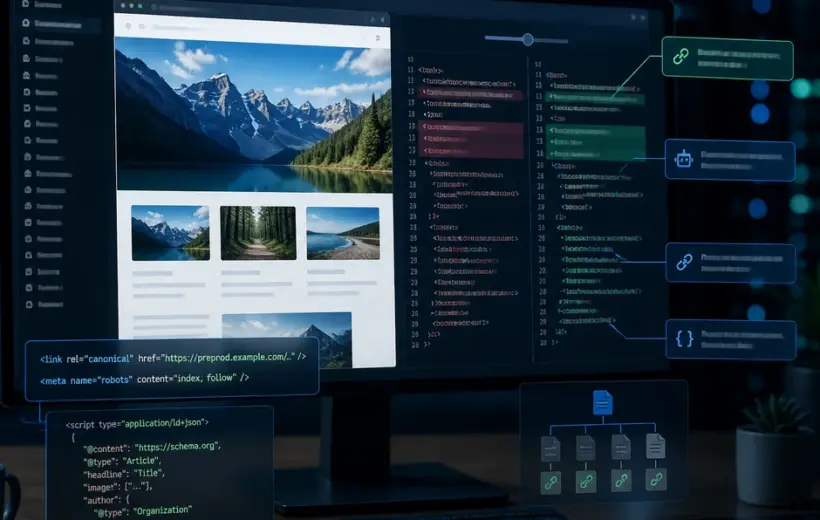
| Modification de template ou de bloc | Préparer plus vite une évolution visible | Rendu, accessibilité, SEO technique et effets de bord | Le contrôle de préproduction ne ralentit pas le gain obtenu |
Cette matrice évite une comparaison trompeuse entre une tâche de documentation et une modification qui touche l’indexation ou l’administration. Plus le changement est exposé, plus le coût de contrôle doit entrer dans la décision.
Le problème : le temps gagné peut être déplacé
Un assistant peut produire une première version utile tout en augmentant la charge de vérification. Dans WordPress, le risque ne se limite pas au PHP visible dans le diff : le comportement dépend aussi des rôles, des hooks, des données déjà présentes, du thème actif, des extensions voisines et du cycle de rendu.
Le calcul doit donc distinguer trois résultats : accepté après contrôle, accepté après correction importante et abandonné. Les trois cas peuvent être utiles pour apprendre, mais ils ne portent pas la même valeur économique. Un résultat abandonné ne doit pas être présenté comme une livraison accélérée.
Une méthode de comparaison en cinq étapes
- Choisir une famille de tâches. Commencer par des demandes répétables et suffisamment étroites pour définir un état initial et un résultat attendu.
- Fixer la référence. Relever le temps habituel sans assistance sur un petit ensemble comparable. La référence doit inclure la vérification normale, pas seulement l’écriture.
- Définir les critères avant la demande. Pour un plugin, préciser par exemple les droits attendus, les entrées valides, les erreurs à conserver et les tests qui doivent rester verts.
- Mesurer la sortie complète. Conserver le temps de préparation, de génération, de revue, de correction et de décision finale. Noter aussi l’abandon ou le retour en arrière.
- Décider par usage. Étendre uniquement les usages dont le gain reste positif après contrôle et dont le niveau de risque est acceptable pour l’équipe.
Une grille de décision simple
Un usage peut être classé dans l’une de quatre zones. « Étendre » signifie que le gain reste visible après revue et que le changement est suffisamment borné. « Encadrer » convient lorsque la valeur existe, mais exige une fixture, une préproduction ou une validation spécialisée. « Réserver » désigne un usage utile seulement à des développeurs capables de relire rapidement les hypothèses. « Arrêter » s’applique lorsque le coût de reprise ou le risque dépasse régulièrement la valeur obtenue.
Cette grille ne remplace pas une mesure. Elle sert à transformer les observations du pilote en règle opérationnelle, au lieu de généraliser l’outil parce que quelques sorties étaient impressionnantes.
Checklist avant de généraliser un usage
- La tâche possède-t-elle un résultat vérifiable et une limite de périmètre ?
- Le temps de revue est-il mesuré séparément du temps de génération ?
- Les échecs, abandons et reprises sont-ils conservés dans le relevé ?
- Les critères WordPress sont-ils explicites : capacités, nonces, validation, échappement, hooks ou compatibilité ?
- Une fixture ou une copie isolée permet-elle de vérifier le comportement sans toucher au site réel ?
- Le coût d’un contrôle humain est-il imputé à l’usage qui le déclenche ?
- Un seuil d’arrêt est-il défini avant l’extension du pilote ?
Le choix pragmatique pour une équipe WordPress
Le meilleur premier pilote n’est pas forcément l’usage qui génère le plus de code. C’est celui dont le résultat est vérifiable, dont le périmètre est limité et dont la revue produit une preuve réutilisable. La documentation ciblée et les tests sur des comportements déjà décrits peuvent constituer un point de départ plus lisible qu’une modification automatique dans l’administration.
Pour les changements de plugin ou de template, le ROI doit rester conditionné à une copie isolée. Commencer par isoler une modification de plugin WordPress avant la pull request permet de borner le changement, de définir les critères de refus et de préparer une revue capable de contrôler le contexte WordPress.
Cette décision doit aussi intégrer mesurer le coût utile des agents IA plutôt que le seul prix affiché du modèle. Le calcul devient alors un outil de décision : il montre où l’IA réduit réellement le coût d’une tâche, et où elle ne fait que déplacer l’effort vers la validation.
Question de la rédaction : dans votre projet WordPress, quel usage de l’IA a réellement réduit le temps total, revue comprise ?
Comment citer
Citez l’URL canonique, l’auteur et la date de mise à jour. Distinguez nos analyses des affirmations de fournisseurs.
Julien Morel. (2026). À quoi sert l’IA dans WordPress quand le coût de revue devient le vrai poste ?. IA News Dev. https://ianewsdev.com/roi-ia-wordpress-cout-revue/ (consulté le 2026-09-28).

dans votre projet WordPress, quel usage de l’IA a réellement réduit le temps total, revue comprise ?
Publié dans la discussion