Un agent peut accélérer l’écriture d’un changement sans accélérer le moment où l’équipe comprend pourquoi il fonctionne — ou pourquoi il échoue. C’est le déplacement du travail que met en avant une enquête de Coleman Parkes réalisée pour Undo, rapportée par Sergio De Simone dans InfoQ le 7 octobre 2026 : la génération de code s’accélère, tandis que le débogage, la compréhension du code et sa maintenance deviennent des points de friction importants. Le titre de l’article évoque aussi davantage d’échecs et un écart de compréhension.
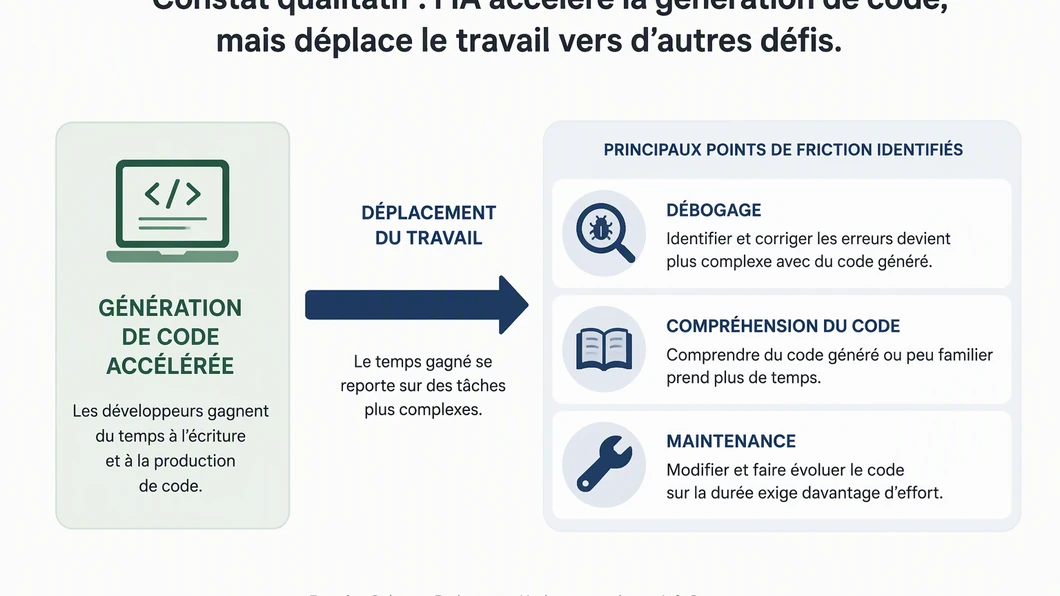
Ce signal ne permet pas, à lui seul, de conclure que tout code généré par IA est moins fiable. Les éléments rapportés ici ne donnent pas de base pour chiffrer l’ampleur du phénomène ni pour comparer des outils. Ils invitent plutôt à poser une question pratique : après la génération, qui sait expliquer le changement, diagnostiquer un échec et le maintenir ?
Le cas d’une modification qui passe, mais reste opaque
Imaginons une équipe qui demande à un agent de modifier un module existant. Le diff paraît cohérent et les vérifications disponibles ne signalent pas de problème. Quelques jours plus tard, un comportement inattendu apparaît dans un autre parcours du produit. Cette scène est hypothétique : elle illustre un risque de travail, pas un incident observé dans l’enquête.
À ce stade, l’équipe ne doit pas seulement retrouver la ligne qui a changé. Elle doit reconstituer l’intention de la modification, les hypothèses prises par l’agent et les parties du système touchées. Si personne ne peut expliquer le cheminement du changement, le dépannage peut s’allonger même si sa production initiale a été rapide. La vitesse de génération et la capacité à maintenir le résultat sont deux choses différentes.
C’est ce décalage qui donne un sens opérationnel à l’expression « écart de compréhension ». Il ne s’agit pas nécessairement d’un manque de compétence individuelle. Le problème peut être collectif : le code est intégré, mais l’équipe n’a pas acquis une représentation assez claire de ses décisions, de ses dépendances ou de ses limites.
Suivre le travail après la génération
Pour examiner ce déplacement dans un projet, il est utile de suivre un changement du début jusqu’à sa maintenance, sans réduire l’observation au temps passé à écrire le diff. Une équipe peut commencer par relever, pour chaque tâche, les éléments suivants :
- le besoin initial et le comportement attendu ;
- les fichiers ou composants modifiés, ainsi que les choix qui nécessitent une explication ;
- les vérifications réellement exécutées et ce qu’elles couvrent ;
- les difficultés de diagnostic apparues pendant la revue ou après l’intégration ;
- la capacité d’un autre membre de l’équipe à expliquer le changement et à intervenir dessus.
Cette liste n’est pas un protocole de recherche et ne reproduit pas l’enquête citée. C’est une façon de rendre visibles les étapes qui peuvent être masquées si l’on ne regarde que la production du code. Elle complète, sans les remplacer, les pratiques de test et de revue déjà adaptées au projet.
Quatre moments à distinguer
| Moment | Question pour l’équipe | Signal à documenter |
|---|---|---|
| Génération | Le changement répond-il à une demande délimitée ? | Intention et périmètre du diff |
| Revue | Peut-on expliquer les décisions prises dans le code ? | Hypothèses et zones encore incertaines |
| Débogage | Peut-on relier un échec au changement concerné ? | Étapes de diagnostic et cause établie, si elle l’est |
| Maintenance | Une autre personne peut-elle reprendre le changement ? | Contexte utile et limites connues |
Le tableau ne présume pas qu’un échec aura lieu. Il aide à séparer les questions : un diff lisible ne prouve pas qu’un comportement est correct, et un contrôle réussi ne garantit pas que l’équipe saura faire évoluer le code plus tard.
Ne pas confondre échec, défaut et manque de compréhension
Un incident observé après une génération ne prouve pas automatiquement que l’IA en est la cause. Le défaut peut venir d’une demande ambiguë, d’une dépendance mal comprise, d’un test insuffisant ou d’un changement ultérieur. Pour éviter une attribution trop rapide, il faut conserver le lien entre le comportement attendu, le diff concerné et les vérifications disponibles.
De même, « davantage de débogage » n’est pas une mesure exploitable tant que l’équipe ne précise pas ce qu’elle observe. S’agit-il d’un problème signalé pendant la revue, d’un échec découvert après intégration ou d’un temps de diagnostic plus important ? Sans définitions communes, ces situations risquent d’être regroupées sous une même étiquette alors qu’elles n’appellent pas les mêmes réponses.
La prudence vaut aussi pour la compréhension. Demander à l’auteur du changement d’en résumer la logique peut révéler les points flous, mais une explication fluide ne constitue pas une preuve de correction. Il faut pouvoir la confronter au comportement attendu et aux éléments vérifiés. Le sujet rejoint celui des compétences d’ingénierie à l’ère de l’IA, sans se réduire à une question d’apprentissage individuel : l’équipe doit aussi organiser la transmission du contexte.
Une lecture utile pour décider, pas un verdict sur les agents
L’enquête rapportée par InfoQ met en avant un déplacement du goulot d’étranglement vers le débogage, la compréhension et la maintenance. Elle ne justifie pas, sur la base des éléments disponibles ici, un taux d’échec précis ni une conclusion universelle sur les outils. Pour une équipe, l’usage immédiat du signal est plus modeste : vérifier si les gains apparents à la génération se retrouvent aussi dans la revue, le diagnostic et la reprise du code.
Un suivi raisonnable peut commencer par quelques changements comparables, avec une définition stable de ce qui compte comme échec, intervention de débogage et difficulté de reprise. Il faut noter ce qui a réellement été observé, y compris les cas où aucune difficulté n’apparaît, et éviter de présenter une impression comme un résultat général. Cette discipline rejoint la démarche consistant à mesurer le ROI de l’IA dans une équipe de développement sans confondre volume produit et valeur livrée.
Le point de décision n’est donc pas « l’IA écrit-elle vite ? », mais « l’équipe peut-elle comprendre, vérifier et maintenir ce qu’elle accepte ? ». Si le coût se déplace vers le diagnostic ou la reprise, il faut le rendre visible avant d’élargir l’usage. Si ce déplacement n’est pas constaté, il n’y a pas lieu de le présumer : documenter les observations permet justement de distinguer le signal général de la réalité du dépôt.
Comment citer
Citez l’URL canonique, l’auteur et la date de mise à jour. Distinguez nos analyses des affirmations de fournisseurs.
Julien Morel. (2026). Code généré par IA : quand le temps gagné revient au débogage. IA News Dev. https://ianewsdev.com/code-genere-ia-debug-maintenance/ (consulté le 2026-10-08).
dans votre équipe, où se concentre le travail après la génération de code par IA ?
Publié dans la discussion